从像素说起:GPU 渲染管线与坐标空间
写 Shader 之前,先弄清楚一个顶点从模型文件出发、最终变成屏幕上一个像素的颜色,中间经过了哪些站点,每一站在哪个坐标系里说话。后面所有章节都站在这一章的地基上。
1.1 一帧画面是怎么来的
屏幕上的每一帧画面,归根结底是一张二维的颜色表:1920×1080 的屏幕就是两百多万个像素,每个像素存一个颜色。而游戏世界是三维的:模型由顶点和三角形组成,有位置、法线、UV;场景里有相机、灯光、材质。渲染管线(Rendering Pipeline)要做的事,就是把“三维世界的描述”翻译成“二维像素的颜色”。
这个翻译过程被拆成一串前后衔接的阶段,像工厂的流水线:前一个阶段的输出是后一个阶段的输入,GPU 让成千上万个顶点、像素同时在流水线上流动。图 1-1 是这条流水线的全景。橙色的阶段是可编程的,也就是我们写的 Shader 代码运行的地方;灰蓝色的阶段是固定功能,由硬件按固定规则执行,我们只能通过渲染状态(如 ZTest、Blend、Cull)去配置它。
把这张图记在脑子里,后面遇到任何渲染问题都可以先问一句:“这件事发生在哪一站?”比如“物体被切掉一半”往往是裁剪或近平面的问题;“贴图在斜面上扭曲”是插值的问题;“透明物体互相遮挡错乱”是逐片元操作(深度写入、混合顺序)的问题。定位到阶段,问题就解决了一半。
URP(Universal Render Pipeline)在这张图里处于最左边:它是运行在 CPU 上的 C# 代码,决定画哪些物体、按什么顺序画、画到哪张纹理上、每一步用哪个 Shader Pass。真正逐顶点、逐像素的计算发生在 GPU 上,由我们写的 Shader 完成。第 2 章会专门剖析 URP 这一侧,本章先把 GPU 这一侧讲透。
1.2 CPU 这一侧:剔除、排序与 Draw Call
GPU 不会自己去“看”场景。每一帧,CPU 都要先替它做好功课:
- 剔除(Culling):用相机视锥体和物体包围盒(Bounds)做相交测试,把完全在视野外的物体剔掉;如果开了遮挡剔除(Occlusion Culling),还会剔掉被大物体完全挡住的物体。剔除是“最便宜的优化”——不画的东西永远最快。
- 排序(Sorting):不透明物体通常从前往后画,让近处物体先写入深度,远处被挡住的像素就能在深度测试阶段被提前丢弃;透明物体必须从后往前画,因为混合依赖于“底下已经有什么颜色”。
- 设置状态并提交绘制命令:对每个要画的物体,CPU 设置好它用的 Shader、纹理、常量(矩阵、材质参数)、渲染状态,然后发出一条“画这个网格”的命令,这就是常说的 Draw Call。切换 Shader/渲染状态的那一步在 Unity 的统计里叫 SetPass Call。
为什么大家总说“Draw Call 多了会卡”?因为每条命令在驱动层都要做验证、翻译、可能还要上传常量数据,这些都是 CPU 时间;而状态切换会让 GPU 刷新内部的管线配置。真正决定开销的往往不是“画了多少次”,而是“切了多少次状态、每次上传了多少数据”。Unity 的各种合批技术——静态合批、动态合批、GPU Instancing,以及 URP 默认开启的 SRP Batcher——都在解决这个问题。SRP Batcher 的原理放在第 2 章讲,因为它直接决定了我们写 Shader 时必须把材质属性放进 CBUFFER_START(UnityPerMaterial)。
ScriptableRenderContext.Cull 完成,“排序 + 生成绘制命令”由 context.DrawRenderers 配合 SortingSettings、FilteringSettings 完成。URP 14 的源码里还有一个细节:如果 GPU 支持隐藏面消除(SystemInfo.hasHiddenSurfaceRemovalOnGPU,例如 Apple GPU),URP 会跳过不透明物体的“由近到远”排序,因为硬件已经替你剔掉了被遮挡的像素(见 UniversalRenderPipeline.cs 中 canSkipFrontToBackSorting)。1.3 顶点着色器:把顶点送进裁剪空间
Draw Call 到达 GPU 后,第一个可编程阶段是顶点着色器(Vertex Shader)。网格里的每个顶点都会独立地执行一次顶点着色器,彼此之间无法通信。它的输入是顶点属性(位置、法线、切线、UV、顶点色……),在 URP 的习惯里写成结构体 Attributes;输出写成结构体 Varyings。
顶点着色器唯一的硬性任务是:输出这个顶点在裁剪空间(Clip Space)中的齐次坐标,并标上语义 SV_POSITION。光栅化器只认这个值,靠它决定三角形落在屏幕哪里。除此之外,你可以往 Varyings 里塞任何想传给片元着色器的数据:世界坐标、法线、UV、雾效因子……它们在光栅化阶段会被插值到三角形内部的每个像素上。
顶点着色器的开销与顶点数成正比。一个 10 万顶点的模型,每帧要跑 10 万次(如果它投射阴影,阴影 Pass 还要再跑一遍)。所以“能在顶点里算的就别在片元里算”是一条老经验——前提是这个量在三角形内线性变化,插值不会带来明显误差。法线、世界坐标适合在顶点里变换;而依赖于像素位置的非线性计算(比如逐像素光照的高光项)就必须放在片元里。
1.4 图元装配与裁剪
顶点着色器算完,GPU 按索引缓冲把顶点三个一组装配成三角形,这叫图元装配(Primitive Assembly)。紧接着是裁剪(Clipping):把视锥体之外的部分切掉。
裁剪是在裁剪空间里、透视除法之前做的,判断条件非常简单——对齐次坐标 :
为什么不先除以 w 再裁剪?因为相机背后的点 w 是负的(1.13 节会看到,透视投影下 w 等于该点到相机的深度)。如果先除,背后的点会被“翻”到前面来,产生完全错误的几何。在齐次空间里用上面这组不等式判断,就不会有这个问题。一个三角形如果部分在视锥外,硬件会沿视锥平面把它切开,生成新的顶点(新顶点的属性也是插值出来的);完全在外的直接丢弃。
现代 GPU 通常还有一个“保护带(Guard Band)”:对于只在 x、y 方向略微超出屏幕的三角形,硬件并不真的切开它,而是让光栅化器直接忽略屏幕外的像素,这样更快。真正必须切的主要是近平面(以及远平面)。这也解释了一个常见现象:物体离相机太近会被“削掉一块”——那是近平面裁剪,把相机的 Near 调小可以缓解,但会牺牲深度精度(见 1.14 节)。
与裁剪紧挨着的还有背面剔除(Back-face Culling):根据三角形在屏幕上的顶点环绕方向(顺时针或逆时针)判断它是正面还是背面,ShaderLab 里的 Cull Back | Front | Off 就是在配置这一步。Unity 约定顺时针为正面。
1.5 透视除法与 NDC
裁剪之后,硬件把每个顶点的 都除以 ,这一步叫透视除法(Perspective Divide),得到的坐标叫标准化设备坐标(NDC,Normalized Device Coordinates)。在 NDC 里,视锥体被“压”成了一个规整的盒子:x、y 都在 [−1, 1],z 在 [0, 1](D3D 风格)或 [−1, 1](OpenGL 风格)。
“近大远小”正是在这一步产生的:远处的点 w 大,除完以后 x、y 变小,往画面中心收拢。从这个角度看,透视投影矩阵本身并不“投影”,它只是把每个点该除的数(深度)悄悄放进了 w 分量,真正的透视效果由硬件的这一次除法完成。
注意 Unity 和 URP 的函数命名里,“NDC”这个词有歧义:URP 的 VertexPositionInputs.positionNDC 并不是上面说的 [−1, 1] 的 NDC,而是“还没除 w 的屏幕坐标”,xy 的范围是 [0, w],除以 w 后得到 [0, 1] 的屏幕 UV。这是为了让它能在片元里正确插值后再除——为什么要这样,案例 1.5 会用一张对比图讲清楚。
1.6 视口变换与屏幕坐标
NDC 还只是一个抽象的盒子,要变成具体的像素位置,还需要视口变换(Viewport Transform):把 [−1, 1] 线性映射到 [0, 宽度]、[0, 高度],把 NDC 的 z 映射到深度缓冲的取值范围。
这里藏着本书反复出现的一个平台差异:OpenGL 的纹理和屏幕坐标原点在左下角,D3D、Metal、Vulkan 在左上角。Unity 为了让同一份 Shader 在所有平台表现一致,做了大量幕后工作——其中之一是:在“左上角原点”的平台上渲染到 RenderTexture 时,会把投影矩阵上下翻转,使得渲染结果作为纹理采样时方向正确。翻转与否记录在 _ProjectionParams.x 里(1 或 −1),Shader 中如果绕开投影矩阵自己构造裁剪坐标,或者自己从像素坐标推算 UV,就必须考虑它。案例 1.3 会实际踩一次这个坑。
片元着色器里拿到的 SV_POSITION 已经不是裁剪坐标,而是视口变换之后的像素坐标:xy 是像素中心(如 100.5, 37.5),z 是将写入深度缓冲的值,w 是插值后的裁剪空间 w。这是初学者最容易混淆的一点:同一个语义,在顶点着色器的输出和片元着色器的输入里含义不同。
1.7 光栅化与插值
光栅化(Rasterization)回答两个问题:这个三角形覆盖了哪些像素?每个被覆盖的像素上,Varyings 里的数据应该是多少?
第一个问题靠“覆盖测试”:判断像素中心是否在三角形内部(落在边上时按“左上规则”决定归属,保证相邻三角形既不重复也不漏画)。开启 MSAA 时,每个像素有多个采样点,覆盖测试按采样点进行,但片元着色器通常仍然每像素只跑一次。
第二个问题靠重心坐标(Barycentric Coordinates):三角形内任意一点 P 都可以写成三个顶点的加权和 ,其中 。顶点上的任何属性(UV、法线、颜色)都可以用同样的权重混合出 P 处的值。
透视校正插值
但这里有一个微妙的问题:重心坐标是在屏幕上算出来的,而属性是定义在三维空间里的。透视投影会把远处压缩,于是屏幕上三角形的“中点”并不对应三维空间里的中点。看图 1-8:一条斜着远去的线段 AB,在屏幕上取中点 M′,它对应的三维点并不是线段的中点 M,而是明显偏向近端 A(近处的一小段在屏幕上占了一大块)。如果直接用屏幕上的比例去插值 UV,近处的纹理会被压缩、远处的纹理会被拉伸。
解决方法是一个漂亮的数学事实:属性 a 本身在屏幕空间不是线性的,但 和 在屏幕空间是线性的。于是硬件分别对它们做线性插值,再相除:
这就是透视校正插值(Perspective-Correct Interpolation),现代 GPU 对 Varyings 默认都这样插值,你什么也不用写。早年的 PlayStation 没有这个硬件,于是游戏里的地砖纹理会在斜看时扭来扭去——这种“仿射插值”的效果在 HLSL 里可以用 noperspective 修饰符故意复现,案例 1.4 就这么做,顺便也会看到它真正的用途:插值“本来就是屏幕空间线性”的量。
normalize。1.8 片元着色器与逐片元操作
光栅化产生的每个“候选像素”叫片元(Fragment)。片元着色器(Fragment Shader,D3D 里叫 Pixel Shader)对每个片元执行一次,输入是插值后的 Varyings,输出颜色(标 SV_Target),也可以输出深度(SV_Depth)。光照、纹理采样、绝大多数“效果”都在这里实现,它通常也是整帧里最昂贵的部分:1080p 下满屏一层就是两百万次执行,再乘上过度绘制(Overdraw)——同一个像素被多个物体重复绘制的次数。
片元着色器算出颜色后,还要经过一串逐片元操作(Per-Fragment Operations)才能真正写进帧缓冲:
- 模板测试(Stencil Test):拿片元的参考值和模板缓冲里的值比较,决定保留还是丢弃,常用来做遮罩、传送门、描边(第 16 章)。
- 深度测试(Depth Test):拿片元深度和深度缓冲里的值比较(
ZTest LEqual等),没通过就丢弃;通过了且ZWrite On就更新深度缓冲。这是“近处挡住远处”的全部秘密。 - 混合(Blending):把片元颜色和颜色缓冲里已有的颜色按
Blend SrcFactor DstFactor公式组合,透明效果靠它(第 16 章)。
Early-Z:为什么 clip() 会变慢
按逻辑顺序,深度测试在片元着色器之后。但如果一个片元注定会被深度测试丢弃,前面跑的着色计算就白费了。所以 GPU 会尽量把深度测试提前到片元着色器之前,这叫 Early-Z(或 Early Depth Test)。被挡住的片元直接跳过着色,省下大量开销——这也是不透明物体要“由近到远”排序的根本原因。
但 Early-Z 有前提:硬件必须在着色之前就确定这个片元的深度、并且确定它一定会写入。以下情况通常会让 Early-Z 失效或打折扣:
- 片元着色器里用了
clip()/discard(Alpha Test):片元可能被丢弃,硬件不能提前写深度; - 片元着色器输出了
SV_Depth:深度要等着色完才知道; - 开启了 Alpha To Coverage 等会在着色后修改覆盖率的功能。
具体行为因 GPU 而异,但原则是一样的:不透明物体尽量别用 clip,必须用(如树叶、栅栏)时,可以考虑先画一遍深度(Depth Prepass)再用 ZTest Equal 着色,URP 的 Depth Priming 选项就是这个思路(第 2 章、第 29 章)。
1.9 移动 GPU:TBDR 简介
上面描述的是“立即模式渲染”(IMR,Immediate Mode Rendering)的思路:三角形一来就光栅化、着色、读写显存里的帧缓冲。桌面 GPU 大体如此,它们有宽阔的显存带宽可以挥霍。
手机就不一样了:显存带宽既慢又耗电,每次读写帧缓冲都在烧电池、发热、降频。于是几乎所有移动 GPU(Apple、Mali、Adreno、PowerVR 等)都采用某种形式的分块渲染(Tile-Based Rendering):先把整帧所有三角形按屏幕上的小块(Tile,如 16×16 或 32×32 像素)分好箱(Binning),然后一块一块地渲染。每个 Tile 的颜色、深度都放在 GPU 芯片上的高速小内存(Tile Memory)里,所有深度测试、混合都在片上完成,整块画完才一次性写回显存。
理解 TBDR 对写 URP 程序有直接意义:
- Load/Store Action:一个 RenderTexture 在开始渲染时要不要从显存“读回来”(Load),结束时要不要“写回去”(Store),在 TBDR 上代价巨大。URP 14 的源码里随处可见
RenderBufferStoreAction.DontCare、Resolve的精心选择(例如在UniversalRenderer.Setup里根据是否需要拷贝深度来决定不透明 Pass 的深度要不要 Store)。 - 切换渲染目标很贵:每次
SetRenderTarget都可能触发一次整屏的 Store + Load。中途“抓一张屏幕纹理”(如 Opaque Texture、自定义后处理)在移动端要格外节制。 - MSAA 在 TBDR 上相对便宜:多重采样数据留在片上、写回时直接解析(Resolve),所以移动端开 2×/4× MSAA 往往比桌面更划算。
- Alpha Test 仍然有害:许多 TBDR GPU 还带有隐藏面消除(HSR / FPK 等),能在着色前剔除被挡住的片元,但
discard会干扰这个机制,道理与 Early-Z 相同。
1.10 坐标空间链:一个顶点的六次“换算”
流水线讲完,我们换一个角度,跟着一个顶点的坐标走一遍。同一个点,在不同的坐标空间(Space)里有不同的数值,每一步换算都是一次矩阵乘法或一次固定的运算。
| 空间 | 原点与朝向 | 典型用途 | URP 变量/函数 |
|---|---|---|---|
| 物体空间 | 模型自己的轴心,建模软件里定的 | 顶点动画、物体内的程序化图案 | positionOS、normalOS |
| 世界空间 | 场景原点,Unity 左手系,+Y 向上 | 光照、阴影、雾、世界坐标贴图 | TransformObjectToWorld、unity_ObjectToWorld |
| 观察空间 | 相机位置为原点,右手系,相机看向 −Z | 按深度做效果、视线相关计算 | TransformWorldToView、UNITY_MATRIX_V |
| 裁剪空间 | 齐次坐标 (x, y, z, w) | 顶点着色器的输出 | TransformWorldToHClip、UNITY_MATRIX_VP |
| NDC | [−1,1]²,z 依平台 | 硬件内部;读写深度图时会遇到 | positionCS.xyz / positionCS.w |
| 屏幕空间 | 像素,原点依平台 | 屏幕空间效果、采样屏幕纹理 | GetNormalizedScreenSpaceUV |
为什么要分这么多空间?因为每个计算都有一个最自然的坐标系。描述“旗子的顶点沿 x 方向摆动”,在物体空间里最简单,不管旗子被摆在世界的哪里、朝哪个方向;计算光照要用到灯光方向、相机位置,这些都定义在世界空间,于是光照在世界空间里算;判断“离相机多远”在观察空间里最直接,深度就是 −z;而硬件只认裁剪空间。学会“在合适的空间里做合适的事”,是写 Shader 的基本功。
1.11 模型矩阵与法线变换
模型矩阵 (Unity 里是 unity_ObjectToWorld,URP 宏 UNITY_MATRIX_M)由物体 Transform 的缩放 S、旋转 R、平移 T 组成,作用顺序是先缩放、再旋转、最后平移:
位置的第四个分量是 1,所以平移会生效;方向向量(如法线、切线、光线方向)的第四个分量是 0,平移对它没有意义,只需要乘左上角的 3×3 部分。URP 的 TransformObjectToWorld 和 TransformObjectToWorldDir 正是这样区分的。
法线不能直接乘 M
如果物体有非均匀缩放(比如 x 方向拉长 2 倍),直接用 M 变换法线会出错。看图 1-12:一个圆被沿水平方向拉成椭圆,表面上的切线 t 被正确地拉伸了,但如果法线 n 也“跟着拉伸”,它就不再垂直于表面。
推导很短。法线的定义是它与表面上任何切向量都垂直:。切向量是表面上两点之差,它跟着 M 正常变换:。我们要找一个矩阵 G 使变换后仍然垂直:
URP 的 TransformObjectToWorldNormal(core 包 SpaceTransforms.hlsl)写的是 mul(normalOS, (float3x3)GetWorldToObjectMatrix()):用行向量左乘逆矩阵,在数学上等于列向量乘逆矩阵的转置,正是上面的结论,而且省掉了一次转置。如果定义了 UNITY_ASSUME_UNIFORM_SCALING,它会退化成直接乘 M 的 3×3 部分——均匀缩放下两者方向相同,归一化后结果一样。
对于纯旋转矩阵,逆等于转置,逆转置就等于它自己,所以“相机矩阵变换法线”可以直接用 V 的 3×3 部分(相机没有缩放)。案例 1.2 会把“错误做法”和“正确做法”的光照并排渲染,并把差异放大给你看。
1.12 观察空间:Unity 的左手与右手
观察矩阵 V 把世界坐标变换到以相机为原点的坐标系里。它本质上是相机 Transform 的逆:相机向前走 1 米,等价于整个世界向后退 1 米。
这里有一个经典的“坑”:Unity 的世界空间是左手系(+X 右、+Y 上、+Z 前),但 Shader 里的观察空间是右手系:+X 右、+Y 上,相机看向 −Z。这是沿袭 OpenGL 的约定——Camera.worldToCameraMatrix 在相机 Transform 的逆的基础上,又把 z 轴取反了。
后果是:观察空间里物体的 z 坐标是负的,深度要写成 -positionVS.z。URP 源码里的注释也反复提醒这一点,例如 ComputeViewSpacePosition 里 “The view space uses a right-handed coordinate system.” 然后执行 positionVS.z = -positionVS.z。你在 C# 里用 camera.worldToCameraMatrix 自己算观察坐标时也一样。
Camera.projectionMatrix 是 OpenGL 约定的“理想矩阵”,不是 GPU 真正用的矩阵。要得到和 Shader 里 UNITY_MATRIX_P 一致的矩阵,需要 GL.GetGPUProjectionMatrix(proj, renderIntoTexture),它会按平台把 z 映射改成 [0,1] 或 Reversed-Z,并在渲染到纹理时翻转 y。1.13 投影矩阵:从视锥到裁剪空间
投影矩阵 P 负责把观察空间里的视锥体变换到裁剪空间。先看最核心的几何关系——相似三角形。设观察空间一点 ,它到相机的深度是 ,投影到距离为 n 的近平面上:
“除以 d”无法用一个矩阵乘法表达(矩阵只能做线性组合),于是投影矩阵用了一个巧妙的办法:把 d 存进 w 分量,让硬件在透视除法时替我们除。Unity 的 Camera.projectionMatrix(OpenGL 约定,θ 为竖直视场角,a 为宽高比)是:
逐行看它做了什么:
- 第一、二行把 x、y 按视场角缩放: 越大(视场越窄),画面越“放大”;第一行再除以宽高比,保证横竖比例正确。
- 第四行是精髓:。透视投影下,裁剪空间的 w 就是观察空间深度(以米为单位)。这个事实非常有用:片元里拿到插值后的 w,就直接得到了这个像素的线性深度,案例 1.1 的第二组图会把它画出来,第 19 章的水面也会用它。
- 第三行把 z 映射成某种“深度值”,它不是线性的——下一节专门讲。
正交投影(Orthographic)则没有“除以深度”这一步,第四行是 ,w 恒为 1,深度是线性的。URP 用 unity_OrthoParams.w(正交为 1)区分两种相机,IsPerspectiveProjection()、GetWorldSpaceViewDir 等函数内部都会判断它。写依赖深度的效果时别忘了正交相机这个分支。
Unity 在把矩阵交给 GPU 前,会通过 GL.GetGPUProjectionMatrix 按平台改写第三行(z 映射)和第二行的符号(渲染到纹理时的 y 翻转)。Shader 里拿到的 UNITY_MATRIX_P、UNITY_MATRIX_VP 都已经是改写后的版本;URP 的 _ProjectionParams 则记录了相关信息:x 为翻转标志(1 或 −1)、y 为近平面 n、z 为远平面 f、w 为 1/f(见 URP 14 ShaderLibrary/UnityInput.hlsl 的注释)。
1.14 深度的非线性与 Reversed-Z
经过投影和透视除法,深度缓冲里存的值(下文称“原始深度”或“设备深度”)与真实距离 d 的关系是一条双曲线。以 D3D 风格的 [0,1] 范围为例:
为什么要设计成非线性?因为只有这种形式(z 与 1/d 成线性关系)才能在屏幕空间里被正确地线性插值——和 1.7 节 “1/w 在屏幕空间线性”是同一个道理。代价是精度分布极不均匀:以 n = 0.5、f = 20 为例,标准深度在 d = 1 米时就已经是 0.51,d = 5 米时是 0.92,后面 15 米的场景挤在 0.92 到 1 之间。
Reversed-Z 把映射反过来:近平面存 1,远平面存 0。看起来只是翻了个面,效果却很大:32 位浮点数在 0 附近的可表示值非常密集,越靠近 1 越稀疏。标准深度把远处挤在 1 附近(浮点最稀疏的地方),两个“不均匀”叠加,远处的深度冲突(Z-Fighting)很严重;Reversed-Z 把远处挤在 0 附近(浮点最密集的地方),两个“不均匀”恰好相互抵消,远处精度大幅改善。所以 D3D11+、Metal、Vulkan 等平台上 Unity 都使用 Reversed-Z,OpenGL 系平台不使用。
对 Shader 作者来说,这意味着三件事:
- 深度测试的比较方向反了。好在 Unity 会自动把 ShaderLab 里的
ZTest LEqual翻译成平台对应的比较,你照常写即可。 - 自己读深度纹理、自己比较深度时,要用
#if UNITY_REVERSED_Z区分。例如“这个像素是不是天空(远平面)”:Reversed-Z 下原始深度为 0,否则为 1。core 包还定义了UNITY_RAW_FAR_CLIP_VALUE方便判断。 - 要把原始深度变回距离,用 URP/core 提供的函数,不要手推:
// 摘自 core 14 ShaderLibrary/Common.hlsl
// 原始深度 → [0,1] 的线性深度(相机处 0,远平面 1;对斜视锥不精确)
float Linear01Depth(float depth, float4 zBufferParam)
{
    return 1.0 / (zBufferParam.x * depth + zBufferParam.y);
}
// 原始深度 → 观察空间深度(米)
float LinearEyeDepth(float depth, float4 zBufferParam)
{
    return 1.0 / (zBufferParam.z * depth + zBufferParam.w);
}
调用时第二个参数传 _ZBufferParams。它的四个分量由引擎按平台填好:标准深度时 x = 1 − f/n、y = f/n;Reversed-Z 时 x = −1 + f/n、y = 1;z = x/f、w = y/f(URP 14 UnityInput.hlsl 注释原文)。代入 Reversed-Z 的情况验证一下:近平面原始深度为 1,;远平面原始深度为 0,结果为 1。正是同一套公式靠参数适配了两种平台,Shader 里无需 #if。
1.15 平台差异速查
本章出现的几处平台差异,在 core 包的 ShaderLibrary/API/*.hlsl 里由宏定义。下表摘自 14.0.12 源码:
| 宏 / 变量 | D3D11 / Metal / Vulkan | OpenGL Core / GLES3 | 含义与用法 |
|---|---|---|---|
UNITY_REVERSED_Z | 1 | 未定义 | 深度是否反转(近 1 远 0) |
UNITY_NEAR_CLIP_VALUE | 1.0 | −1.0 | 近裁剪面的 NDC z 值 |
UNITY_RAW_FAR_CLIP_VALUE | 0.0 | 1.0 | 远平面的原始深度值,判断“天空”时用 |
UNITY_UV_STARTS_AT_TOP | 1 | 未定义 | 纹理/屏幕 v 坐标原点在顶部 |
_ProjectionParams.x | 1 或 −1,运行时决定 | 当前投影矩阵是否上下翻转(渲染到 RT 时常为 −1) | |
需要强调:UNITY_UV_STARTS_AT_TOP 是编译期的“平台属性”,而 _ProjectionParams.x 是运行时的“这一次渲染有没有翻转”。同一个平台上,渲染到屏幕和渲染到 RenderTexture 可能不同。所以在 URP 里:凡是从裁剪坐标推屏幕坐标,乘 _ProjectionParams.x(GetVertexPositionInputs 里就是这么做的);凡是从像素坐标推 UV,用 GetNormalizedScreenSpaceUV,它内部借助 _ScaleBiasRt 处理了翻转。
1.16 URP 中的对应函数
理论讲完,看看 URP 把这些换算封装成了哪些函数。最常用的是 GetVertexPositionInputs,一次算出各个空间的位置:
// 摘自 URP 14 ShaderLibrary/ShaderVariablesFunctions.hlsl
VertexPositionInputs GetVertexPositionInputs(float3 positionOS)
{
    VertexPositionInputs input;
    input.positionWS = TransformObjectToWorld(positionOS);
    input.positionVS = TransformWorldToView(input.positionWS);
    input.positionCS = TransformWorldToHClip(input.positionWS);

    float4 ndc = input.positionCS * 0.5f;
    input.positionNDC.xy = float2(ndc.x, ndc.y * _ProjectionParams.x) + ndc.w;
    input.positionNDC.zw = input.positionCS.zw;

    return input;
}
注意 positionNDC 的算法:,再乘上翻转标志。它把 [−w, w] 映射到 [0, w],没有除以 w。除以 w 之后才是 [0, 1] 的屏幕 UV。旧版 Built-in 管线的 ComputeScreenPos 在 URP 14 里仍然存在,但已放进 ShaderVariablesFunctions.deprecated.hlsl,注释写明“用 GetVertexPositionInputs().positionNDC 代替”,两者算法完全相同。
如果不需要全部空间,GPU 编译器会把没用到的计算优化掉,所以放心调用;只需要裁剪坐标时,也可以直接用 TransformObjectToHClip。常用函数汇总如下:
| 函数 | 所在文件 | 作用 |
|---|---|---|
TransformObjectToWorld(p) | core SpaceTransforms.hlsl | 位置:物体 → 世界 |
TransformWorldToView(p) | 同上 | 位置:世界 → 观察(右手系) |
TransformWorldToHClip(p) / TransformObjectToHClip(p) | 同上 | 位置:世界/物体 → 裁剪空间 |
TransformObjectToWorldDir(d) | 同上 | 方向:只乘 3×3,默认归一化 |
TransformObjectToWorldNormal(n) | 同上 | 法线:乘逆转置,默认归一化 |
TransformWorldToViewDir(d) | 同上 | 方向:世界 → 观察 |
GetVertexPositionInputs(p) | URP ShaderVariablesFunctions.hlsl | 一次算出 WS / VS / CS / positionNDC |
GetVertexNormalInputs(n, t) | 同上 | 世界空间法线、切线、副切线 |
GetNormalizedScreenSpaceUV(positionCS) | 同上 | 片元里由 SV_POSITION 求 [0,1] 屏幕 UV |
GetCameraPositionWS() / GetWorldSpaceViewDir(p) | 同上 | 相机位置、指向相机的方向(区分正交/透视) |
Linear01Depth / LinearEyeDepth | core Common.hlsl | 原始深度 → 线性深度 |
SampleSceneDepth(uv) | URP DeclareDepthTexture.hlsl | 采样相机深度纹理(原始深度) |
ComputeWorldSpacePosition(uv, depth, invVP) | core Common.hlsl | 由屏幕 UV + 原始深度重建世界坐标(第 28 章) |
案例 1.1坐标空间“调色板”:把各个空间画出来入门单独打开 ↗
目标:写一个调试 Shader,把一个点在物体空间、世界空间、观察空间、NDC、裁剪空间 w、像素坐标下的值“涂”在物体表面上,用眼睛直观地感受每个空间的特点。
原理:顶点着色器里用 GetVertexPositionInputs 一次算出所有空间的位置,统统放进 Varyings,交给光栅化器插值;片元着色器按 _Mode 选择把哪一个映射成颜色。网格线用 frac 找整数位置、用 fwidth 控制线宽(第 4 章详细讲)。有一点要特别注意:片元里的 SV_POSITION 已经变成像素坐标,想在片元里拿到裁剪坐标,得另外用一个 TEXCOORD 传一份拷贝。
struct Varyings
{
    float4 positionCS  : SV_POSITION; // 交给光栅化器:裁剪空间坐标(到了片元里会变成像素坐标)
    float3 positionOS  : TEXCOORD0;   // 物体空间
    float3 positionWS  : TEXCOORD1;   // 世界空间
    float3 positionVS  : TEXCOORD2;   // 观察空间(右手系,相机看向 -Z)
    float4 positionHCS : TEXCOORD3;   // 裁剪空间的一份拷贝:SV_POSITION 在片元阶段已被改写,想要原值得自己传
};

Varyings vert(Attributes input)
{
    Varyings output;
    // URP 一次性算好各个空间的位置(ShaderVariablesFunctions.hlsl)
    VertexPositionInputs pos = GetVertexPositionInputs(input.positionOS.xyz);
    output.positionCS  = pos.positionCS;
    output.positionOS  = input.positionOS.xyz;
    output.positionWS  = pos.positionWS;
    output.positionVS  = pos.positionVS;
    output.positionHCS = pos.positionCS;
    return output;
}
// 交给光栅化器的裁剪空间坐标写进 gl_Position(到了片元里会变成像素坐标 gl_FragCoord)
VARYING vec3 vPositionOS;   // 物体空间
VARYING vec3 vPositionWS;   // 世界空间
VARYING vec3 vPositionVS;   // 观察空间(右手系,相机看向 -Z)
VARYING vec4 vPositionHCS;  // 裁剪空间的一份拷贝:gl_FragCoord 在片元阶段已被改写,想要原值得自己传

#ifdef VERTEX
void main()
{
    // URP 一次性算好各个空间的位置(ShaderVariablesFunctions.hlsl)
    VertexPositionInputs pos = GetVertexPositionInputs(positionOS.xyz);
    gl_Position  = pos.positionCS;
    vPositionOS  = positionOS.xyz;
    vPositionWS  = pos.positionWS;
    vPositionVS  = pos.positionVS;
    vPositionHCS = pos.positionCS;
}
#endif
half4 frag(Varyings input) : SV_Target
{
    float3 col = 0;
    int mode = (int)_Mode;

    if (mode == 0)          // 物体空间:坐标跟着物体走,旋转缩放物体,图案跟着转
    {
        col = saturate(input.positionOS + 0.5);
        col = lerp(col, 0.05, GridLine(input.positionOS, 0.25 * _GridSize));
    }
    else if (mode == 1)     // 世界空间:所有物体共用一套坐标,网格线在物体之间连续
    {
        float3 cell = frac(input.positionWS / _GridSize);
        col = 0.25 + 0.6 * cell;
        col = lerp(col, 0.05, GridLine(input.positionWS, _GridSize));
        // 世界原点处的 X 轴(红)、Z 轴(蓝)
        float ax = 1.0 - saturate(abs(input.positionWS.z) / (2.0 * fwidth(input.positionWS.z)));
        float az = 1.0 - saturate(abs(input.positionWS.x) / (2.0 * fwidth(input.positionWS.x)));
        col = lerp(col, float3(1, 0.1, 0.1), ax);
        col = lerp(col, float3(0.1, 0.3, 1), az);
    }
    else if (mode == 2)     // 观察空间:x 向右、y 向上,深度 = -z
    {
        float depth = -input.positionVS.z;
        col.rg = saturate(input.positionVS.xy * 0.25 + 0.5);
        col.b  = saturate(depth / _DepthScale);
        // 等深线:每 1 米一条,它们都与相机的成像平面平行
        float iso = abs(frac(depth - 0.5) - 0.5) / max(fwidth(depth), 1e-5);
        col = lerp(col, 1.0, 1.0 - saturate(iso - 0.5));
    }
    else if (mode == 3)     // NDC:透视除法之后,可见范围 x、y 都在 [-1, 1]
    {
        float2 ndc = input.positionHCS.xy / input.positionHCS.w;
        ndc.y *= _ProjectionParams.x;      // 渲染到 RT 时投影矩阵被上下翻转过,这里翻回来,让 +y 永远朝上
        col = float3(saturate(ndc.x), saturate(ndc.y), saturate(-ndc.x) * 0.7 + saturate(-ndc.y) * 0.3);
        col = lerp(col, 0.0, GridLine2(ndc, 0.25));
        col = lerp(col, 1.0, GridLine2(ndc, 1.0));   // 中心十字(x=0、y=0)
    }
    else if (mode == 4)     // 裁剪空间的 w:透视投影下它就是观察空间深度
    {
        float w = input.positionHCS.w;
        col = saturate(w / _DepthScale).xxx;
        float iso = abs(frac(w - 0.5) - 0.5) / max(fwidth(w), 1e-5);
        col = lerp(col, float3(1, 0.45, 0.2), 1.0 - saturate(iso - 0.5));
    }
    else                    // 片元阶段的 SV_POSITION.xy:像素中心坐标(如 100.5, 37.5)
    {
        float2 cell = floor(input.positionCS.xy / _PixelCell);
        float k = fmod(cell.x + cell.y, 2.0);
        col = lerp(float3(0.9, 0.9, 0.92), float3(0.25, 0.45, 0.6), k);
    }
    return half4(col, 1);
}
void main()
{
    vec3 col = vec3(0.0);
    int mode = int(_Mode);

    if (mode == 0)          // 物体空间:坐标跟着物体走,旋转缩放物体,图案跟着转
    {
        col = saturate(vPositionOS + 0.5);
        col = mix(col, vec3(0.05), GridLine(vPositionOS, 0.25 * _GridSize));
    }
    else if (mode == 1)     // 世界空间:所有物体共用一套坐标,网格线在物体之间连续
    {
        vec3 cell = fract(vPositionWS / _GridSize);
        col = 0.25 + 0.6 * cell;
        col = mix(col, vec3(0.05), GridLine(vPositionWS, _GridSize));
        // 世界原点处的 X 轴(红)、Z 轴(蓝)
        float ax = 1.0 - saturate(abs(vPositionWS.z) / (2.0 * fwidth(vPositionWS.z)));
        float az = 1.0 - saturate(abs(vPositionWS.x) / (2.0 * fwidth(vPositionWS.x)));
        col = mix(col, vec3(1, 0.1, 0.1), ax);
        col = mix(col, vec3(0.1, 0.3, 1), az);
    }
    else if (mode == 2)     // 观察空间:x 向右、y 向上,深度 = -z
    {
        float depth = -vPositionVS.z;
        col.rg = saturate(vPositionVS.xy * 0.25 + 0.5);
        col.b  = saturate(depth / _DepthScale);
        // 等深线:每 1 米一条,它们都与相机的成像平面平行
        float iso = abs(fract(depth - 0.5) - 0.5) / max(fwidth(depth), 1e-5);
        col = mix(col, vec3(1.0), 1.0 - saturate(iso - 0.5));
    }
    else if (mode == 3)     // NDC:透视除法之后,可见范围 x、y 都在 [-1, 1]
    {
        vec2 ndc = vPositionHCS.xy / vPositionHCS.w;
        ndc.y *= _ProjectionParams.x;      // 渲染到 RT 时投影矩阵被上下翻转过,这里翻回来,让 +y 永远朝上(WebGL 里恒为 1)
        col = vec3(saturate(ndc.x), saturate(ndc.y), saturate(-ndc.x) * 0.7 + saturate(-ndc.y) * 0.3);
        col = mix(col, vec3(0.0), GridLine2(ndc, 0.25));
        col = mix(col, vec3(1.0), GridLine2(ndc, 1.0));   // 中心十字(x=0、y=0)
    }
    else if (mode == 4)     // 裁剪空间的 w:透视投影下它就是观察空间深度
    {
        float w = vPositionHCS.w;
        col = vec3(saturate(w / _DepthScale));
        float iso = abs(fract(w - 0.5) - 0.5) / max(fwidth(w), 1e-5);
        col = mix(col, vec3(1, 0.45, 0.2), 1.0 - saturate(iso - 0.5));
    }
    else                    // 片元阶段的 gl_FragCoord.xy:像素中心坐标(如 100.5, 37.5)
    {
        // 注意:Unity(D3D)的像素坐标原点在左上角,WebGL 在左下角,棋盘格的起点会差半格
        vec2 cell = floor(gl_FragCoord.xy / _PixelCell);
        float s = cell.x + cell.y;
        float k = s - 2.0 * trunc(s / 2.0);    // fmod(s, 2)
        col = mix(vec3(0.9, 0.9, 0.92), vec3(0.25, 0.45, 0.6), k);
    }
    fragColor = vec4(col, 1);
}
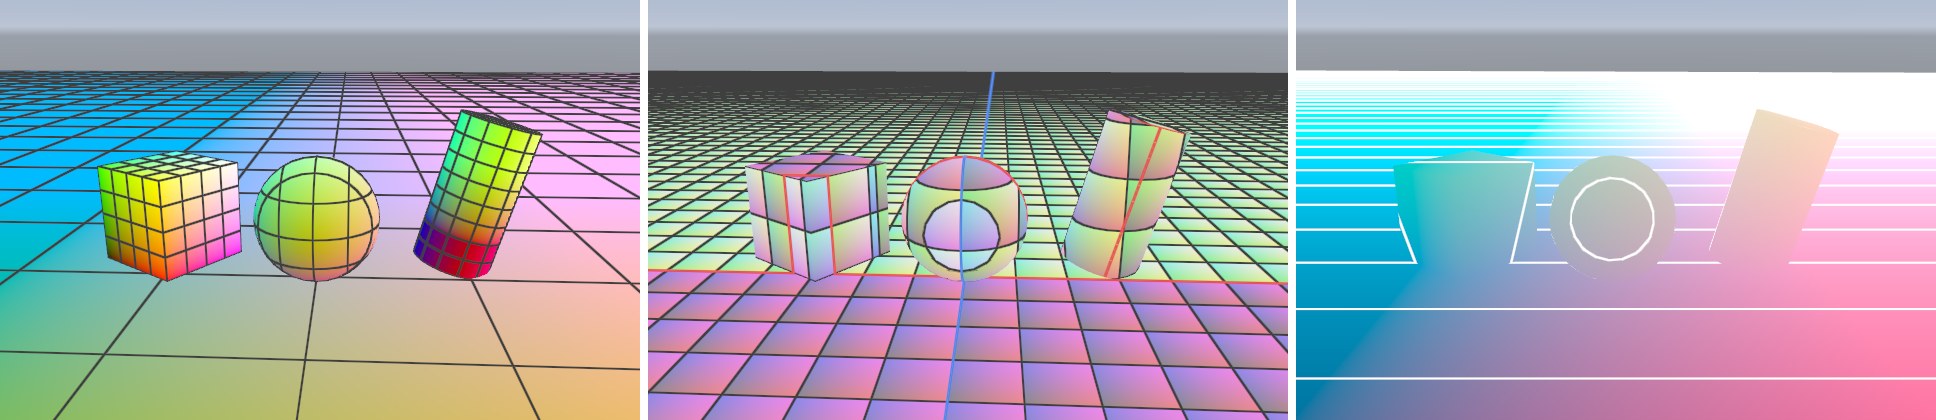
三张图对照着看:
- 物体空间里,立方体和圆柱体的网格贴着各自的表面走,圆柱被旋转了 15°,网格也跟着歪;地面的网格间距和立方体不同,因为地面(Unity 自带的 Plane)在物体空间里是 10×10 的,被缩放了 6 倍。物体空间的坐标不关心物体在世界里的位置和姿态,所以顶点动画、物体内的程序化图案通常在这里做。
- 世界空间里,所有物体共用一套网格,网格线从地面“爬”上物体表面也不断开。被旋转的圆柱体上,网格依然是横平竖直的。世界坐标贴图、三平面映射(第 20 章)利用的正是这一点。
- 观察空间的等深线全部是“横线”——它们是一组与相机成像平面平行的切片。这直观地说明了“观察空间深度 = 到相机所在平面的距离”,而不是到相机那个点的欧氏距离。
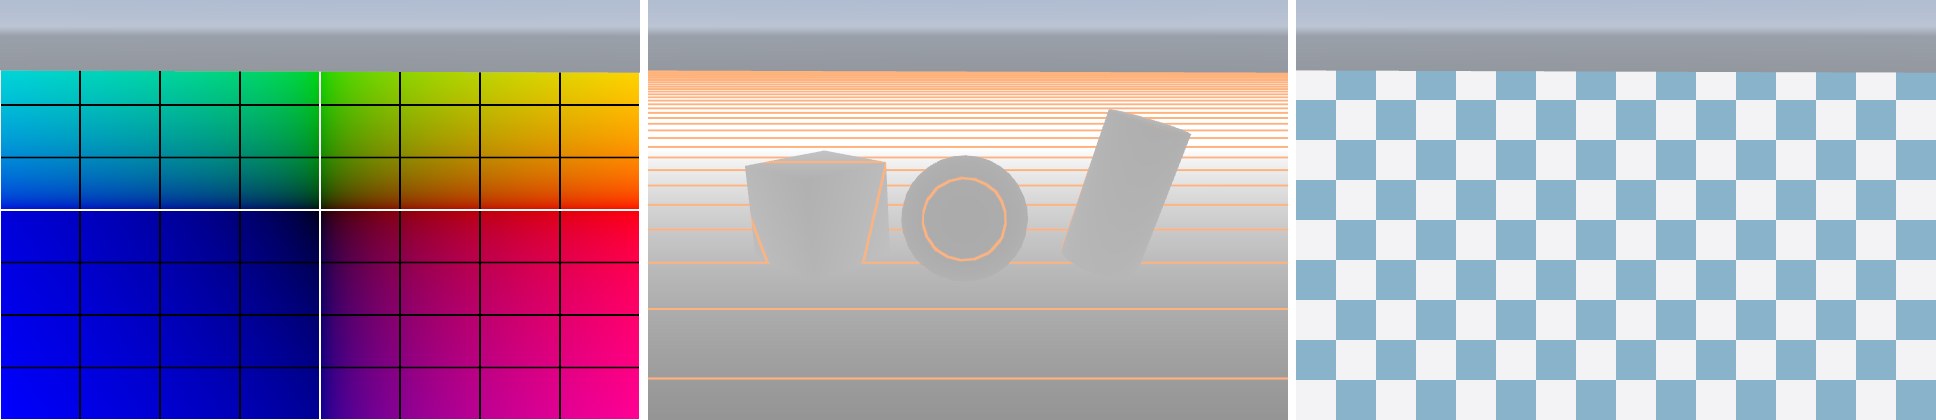
第二组图更有意思。左图里三个物体“消失”了——NDC 的 xy 只取决于这个点落在屏幕的什么位置,和它属于哪个物体、离多远都无关,所以整个画面就是一张平滑的渐变,四个象限被白色十字分开。代码里 ndc.y *= _ProjectionParams.x 这一行如果删掉,在渲染到 RenderTexture 的情况下(例如 URP 默认开启的中间缓冲),上下两半的颜色会对调。中图证明了 1.13 节的结论:w 的等值线与右上图观察空间的等深线完全一致,透视投影下 clip.w 就是观察空间深度。右图则是片元阶段的 SV_POSITION:规整的像素格子,与三维几何毫无关系。
案例 1.2法线可视化与非均匀缩放的坑入门单独打开 ↗
目标:把物体空间、世界空间、观察空间的法线分别画出来;再用“正确”和“错误”两种方式变换法线并计算漫反射,对比非均匀缩放下的差异。
原理:法线分量在 [−1, 1],乘 0.5 加 0.5 映射到 [0, 1] 就能当颜色显示——这也是法线贴图的编码方式,所以“法线图”看起来偏蓝紫(朝向 +Z 的分量大)。错误做法用 TransformObjectToWorldDir(只乘 M 的 3×3),正确做法用 TransformObjectToWorldNormal(乘逆转置)。
Varyings vert(Attributes input)
{
    Varyings output;
    output.positionCS = TransformObjectToHClip(input.positionOS.xyz);
    output.normalOS   = input.normalOS;

    // 正确:乘“模型矩阵的逆转置”。URP 的实现是 mul(normalOS, (float3x3)WorldToObject),
    // 行向量左乘逆矩阵,等价于列向量左乘逆矩阵的转置(SpaceTransforms.hlsl)
    output.normalWS = TransformObjectToWorldNormal(input.normalOS);

    // 错误:把法线当成普通方向,直接乘模型矩阵。均匀缩放时没问题,非均匀缩放时法线不再垂直于表面
    output.normalWSWrong = TransformObjectToWorldDir(input.normalOS);

    // 观察空间法线:方向只受旋转影响,用 3x3 的观察矩阵即可(相机矩阵不含缩放)
    output.normalVS = TransformWorldToViewDir(output.normalWS);
    return output;
}
#ifdef VERTEX
void main()
{
    gl_Position = TransformObjectToHClip(positionOS.xyz);
    vNormalOS   = normalOS;

    // 正确:乘“模型矩阵的逆转置”。URP 的实现是 mul(normalOS, (float3x3)WorldToObject),
    // 行向量左乘逆矩阵,等价于列向量左乘逆矩阵的转置(SpaceTransforms.hlsl)
    vNormalWS = TransformObjectToWorldNormal(normalOS);

    // 错误:把法线当成普通方向,直接乘模型矩阵。均匀缩放时没问题,非均匀缩放时法线不再垂直于表面
    vNormalWSWrong = TransformObjectToWorldDir(normalOS);

    // 观察空间法线:方向只受旋转影响,用 3x3 的观察矩阵即可(相机矩阵不含缩放)
    vNormalVS = TransformWorldToViewDir(vNormalWS);
}
#endif
half4 frag(Varyings input) : SV_Target
{
    // 插值后的法线长度会小于 1,必须重新归一化
    float3 nOS = normalize(input.normalOS);
    float3 nWS = normalize(input.normalWS);
    float3 nWrong = normalize(input.normalWSWrong);
    float3 nVS = normalize(input.normalVS);

    int mode = (int)_Mode;
    half3 col;
    if (mode == 0)      col = nOS * 0.5 + 0.5;   // [-1,1] 映射到 [0,1] 才能当颜色看
    else if (mode == 1) col = nWS * 0.5 + 0.5;
    else if (mode == 2) col = nVS * 0.5 + 0.5;
    else if (mode == 3) col = Lambert(nWS);
    else if (mode == 4) col = Lambert(nWrong);
    else                col = abs(Lambert(nWS) - Lambert(nWrong)) * 4.0;
    return half4(col, 1);
}
void main()
{
    // 插值后的法线长度会小于 1,必须重新归一化
    vec3 nOS = normalize(vNormalOS);
    vec3 nWS = normalize(vNormalWS);
    vec3 nWrong = normalize(vNormalWSWrong);
    vec3 nVS = normalize(vNormalVS);

    int mode = int(_Mode);
    vec3 col;
    if (mode == 0)      col = nOS * 0.5 + 0.5;   // [-1,1] 映射到 [0,1] 才能当颜色看
    else if (mode == 1) col = nWS * 0.5 + 0.5;
    else if (mode == 2) col = nVS * 0.5 + 0.5;
    else if (mode == 3) col = Lambert(nWS);
    else if (mode == 4) col = Lambert(nWrong);
    else                col = abs(Lambert(nWS) - Lambert(nWrong)) * 4.0;
    fragColor = vec4(col, 1);
}

看立方体:它被旋转过,物体空间里它的正面法线是 (0,0,−1),世界空间里却朝向别处,所以左、中两图同一个面颜色不同。地面没有旋转,物体空间和世界空间法线都是 (0,1,0),所以都是同一种绿色;到了观察空间,“向上”在相机看来是略微朝向观察者的,颜色就带上了蓝色——观察空间里 +Z 指向观察者(1.12 节)。
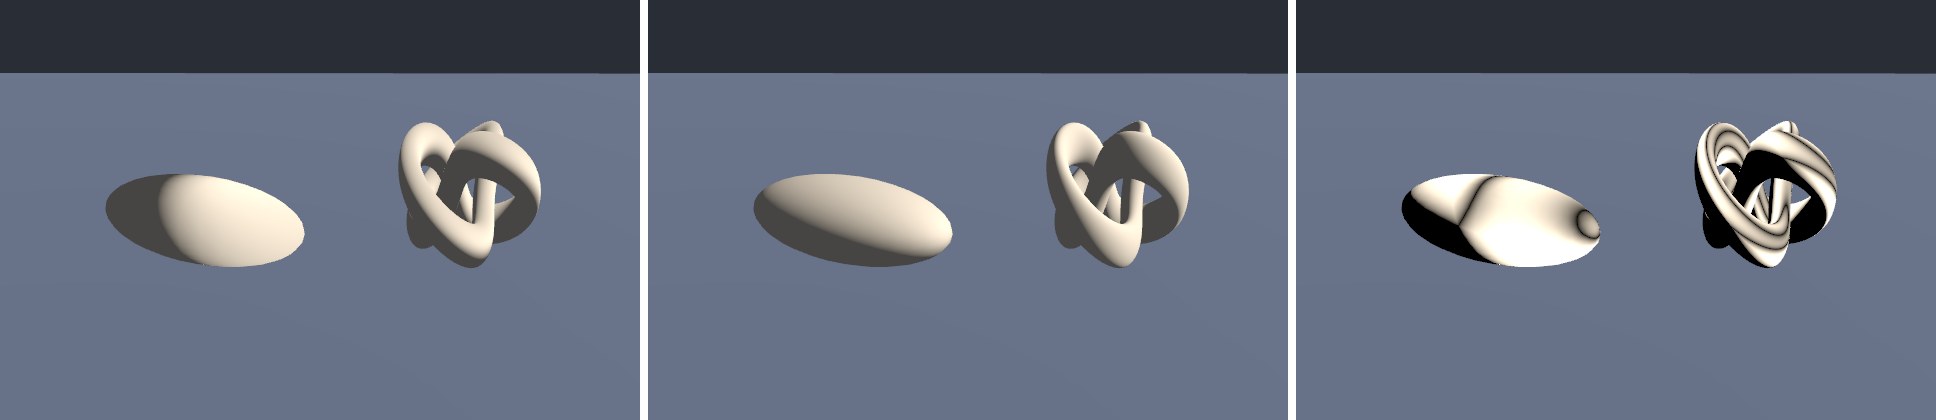
左、中两图乍看都“像那么回事”,但明暗交界线的位置不同:错误的法线被拉向了缩放倍数大的方向,压扁的球顶部本应接近正对上方,却被算成了偏向侧面。右图把差异放大 4 倍,白色区域就是光照算错的地方,面积相当可观。实际项目里,这类错误通常表现为“某个被拉伸过的模型光照怪怪的”,很难第一时间想到是法线变换的问题——用 URP 的 TransformObjectToWorldNormal 或 GetVertexNormalInputs,就不会踩这个坑。
案例 1.3在裁剪空间里直接画:原始深度 vs 线性深度进阶单独打开 ↗
目标:读取 URP 的相机深度纹理 _CameraDepthTexture,分别显示原始深度、Linear01Depth、LinearEyeDepth,亲眼看看深度的非线性。顺便练习一个重要技巧:顶点着色器不乘任何矩阵,直接给出裁剪空间坐标,画一个盖满屏幕的四边形。
原理:Unity 的 Quad 网格顶点在 [−0.5, 0.5],乘 2 就是 [−1, 1];令 w = 1,透视除法后 NDC 正好覆盖整个屏幕。z 放在近平面 UNITY_NEAR_CLIP_VALUE 上保证不被裁掉(并关闭深度测试)。因为绕开了投影矩阵,就要自己处理渲染到纹理时的 y 翻转:乘 _ProjectionParams.x。片元里用 GetNormalizedScreenSpaceUV 把像素坐标变成屏幕 UV,再 SampleSceneDepth。
Varyings vert(Attributes input)
{
    Varyings output;
    // 直接给出裁剪空间坐标:w = 1,所以透视除法后 NDC = (x, y)。
    // z 放在近裁剪面 UNITY_NEAR_CLIP_VALUE(D3D/Metal/Vulkan 是 1,OpenGL 是 -1),保证不被裁掉
    output.positionCS = float4(input.positionOS.xy * 2.0, UNITY_NEAR_CLIP_VALUE, 1.0);
    // 渲染到中间 RT 时,Unity 的投影矩阵会上下翻转(_ProjectionParams.x = -1)。
    // 我们绕过了投影矩阵,就要手动跟它保持一致,否则画面会倒过来
    output.positionCS.y *= _ProjectionParams.x;
    return output;
}
#ifdef VERTEX
void main()
{
    // 直接给出裁剪空间坐标:w = 1,所以透视除法后 NDC = (x, y)。
    // z 放在近裁剪面 UNITY_NEAR_CLIP_VALUE(D3D/Metal/Vulkan 是 1,OpenGL/WebGL 是 -1),保证不被裁掉
    gl_Position = vec4(positionOS.xy * 2.0, UNITY_NEAR_CLIP_VALUE, 1.0);
    // 渲染到中间 RT 时,Unity 的投影矩阵会上下翻转(_ProjectionParams.x = -1)。
    // 我们绕过了投影矩阵,就要手动跟它保持一致,否则画面会倒过来(WebGL 里恒为 1)
    gl_Position.y *= _ProjectionParams.x;
}
#endif
half4 frag(Varyings input) : SV_Target
{
    // 片元里的 SV_POSITION.xy 是像素坐标,除以屏幕尺寸得到 [0,1] 的屏幕 UV(内部处理了平台翻转)
    float2 uv = GetNormalizedScreenSpaceUV(input.positionCS);
    float raw = SampleSceneDepth(uv);

    int mode = (int)_Mode;
    // 线性色彩空间的工程里,颜色写进 sRGB 目标时会被“提亮”(0.07 显示成约 0.3)。
    // 调试数值时先做一次 SRGBToLinear 抵消它,屏幕上的灰度才等于数值本身。
    if (mode == 0)
        return half4(SRGBToLinear(raw.xxx), 1);         // 原样输出,不做任何“美化”

    if (mode == 1)
    {
        float d01 = Linear01Depth(raw, _ZBufferParams);  // 相机处 0(实际从 near/far 开始),远裁剪面处 1
        return half4(SRGBToLinear(d01.xxx), 1);
    }

    float eye = LinearEyeDepth(raw, _ZBufferParams);    // 单位:米,沿相机前方的距离
    float band = frac(eye / _BandWidth);
    float3 col = lerp(float3(0.10, 0.35, 0.55), float3(0.95, 0.55, 0.25), saturate(eye / _EyeMax));
    col *= 0.55 + 0.45 * step(0.5, band);              // 交替明暗:每条色带一样宽 → 说明 eye 是线性的
    return half4(col, 1);
}
#ifdef FRAGMENT
void main()
{
    // 片元里的 gl_FragCoord.xy 是像素坐标,除以屏幕尺寸得到 [0,1] 的屏幕 UV
    vec2 uv = GetNormalizedScreenSpaceUV(gl_FragCoord);
    float raw = SampleSceneDepth(uv);

    int mode = int(_Mode);
    // 线性色彩空间的工程里,颜色写进 sRGB 目标时会被“提亮”(0.07 显示成约 0.3)。
    // 调试数值时先做一次 SRGBToLinear 抵消它,屏幕上的灰度才等于数值本身。
    if (mode == 0)
    {
        fragColor = vec4(SRGBToLinear(vec3(raw)), 1);   // 原样输出,不做任何“美化”
        return;
    }

    if (mode == 1)
    {
        float d01 = Linear01Depth(raw, _ZBufferParams);  // 相机处 0(实际从 near/far 开始),远裁剪面处 1
        fragColor = vec4(SRGBToLinear(vec3(d01)), 1);
        return;
    }

    float eye = LinearEyeDepth(raw, _ZBufferParams);    // 单位:米,沿相机前方的距离
    float band = fract(eye / _BandWidth);
    vec3 col = mix(vec3(0.10, 0.35, 0.55), vec3(0.95, 0.55, 0.25), saturate(eye / _EyeMax));
    col *= 0.55 + 0.45 * step(0.5, band);              // 交替明暗:每条色带一样宽 → 说明 eye 是线性的
    fragColor = vec4(col, 1);
}
#endif
这个 Shader 放在透明队列(Transparent+100),保证在所有不透明物体之后绘制。这里有一个 URP 14 的细节:Universal Renderer 的 Depth Texture Mode 新建工程默认是 After Transparents(UniversalRendererData.m_CopyDepthMode 的默认值),也就是深度在透明物体之后才拷贝到 _CameraDepthTexture——透明物体读到的不是当前帧的深度。配图脚本里把它改成了 CopyDepthMode.AfterOpaques,你在编辑器里要在 Renderer 资产的 Inspector 中把 Depth Texture Mode 设为 After Opaques。第 2 章会细讲这个开关。
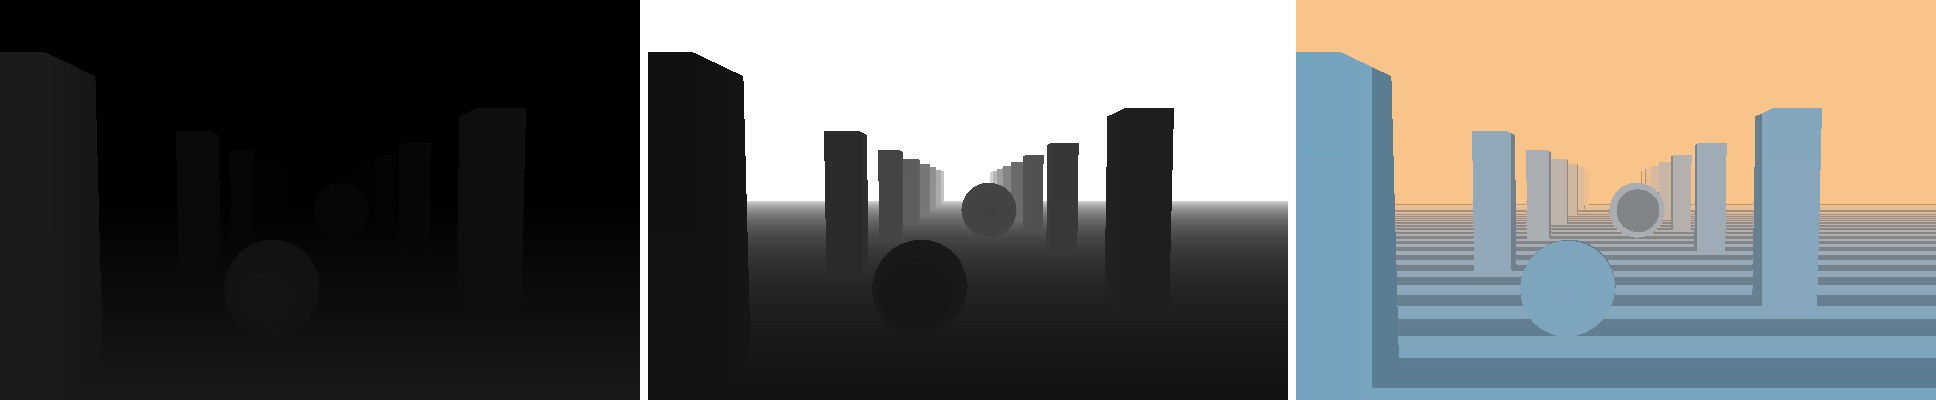
左图几乎全黑——这不是 bug,而是 Reversed-Z 原始深度的真实面貌:只有离相机一两米内的地面还有一点灰度,其余场景都挤在接近 0 的数值里(对照图 1-15 的曲线)。中图的 Linear01Depth 才是直觉中的“深度图”:由近到远均匀变亮,天空处为 1(远平面)。右图的色带宽度在画面上近宽远窄,但在三维空间里每条都正好 1 米——这证明 LinearEyeDepth 的单位就是米,可以直接拿去和物体的观察深度相减,算“水有多深”“粒子离墙多近”(第 19、21 章)。
SRGBToLinear,抵消线性工程写入 sRGB 帧缓冲时的编码。不做这一步,左图会显得灰蒙蒙的,从而误以为深度值比实际大得多。调试“数值”时这是个好习惯。常见坑:
- 深度纹理一片纯黑或纯白:URP Asset 里没勾 Depth Texture,URP 会把
_CameraDepthTexture设成一张代表“远平面”的纹理(Reversed-Z 平台为黑色)。 - 画面上下颠倒:顶点里忘了乘
_ProjectionParams.x,或者自己用positionCS.xy / _ScreenParams.xy算 UV 而没处理翻转。 - 全屏四边形不显示:它的 MeshRenderer 仍然要经过 CPU 视锥剔除,包围盒必须在相机视野内(配图脚本把它放在相机正前方 2 米处)。第 25 章用 Renderer Feature 画全屏,就不再有这个问题。
案例 1.4透视校正插值 vs 仿射插值入门单独打开 ↗
目标:复现 1.7 节说的“仿射插值”,看看没有透视校正的纹理是什么样子。
原理:HLSL 允许给 Varyings 的成员加插值修饰符(Interpolation Modifier)。noperspective 让这个值在屏幕空间里线性插值,跳过透视校正。同一份 UV 传两遍,一份默认,一份加 noperspective,片元里用开关选择。
struct Varyings
{
    float4 positionCS : SV_POSITION;
    float2 uv         : TEXCOORD0;   // 默认:透视校正插值
    noperspective float2 uvAffine : TEXCOORD1; // 在屏幕空间里线性插值(PS1 时代的效果)
};
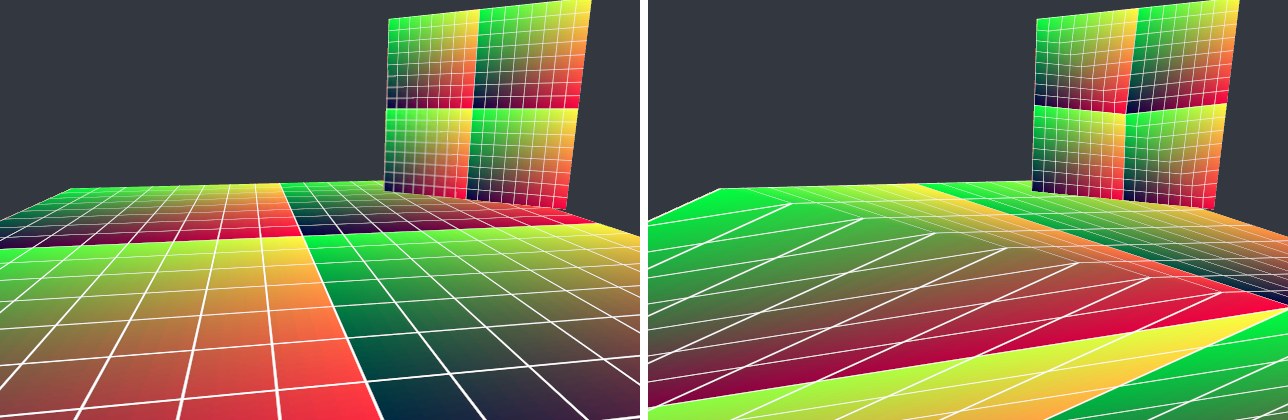
右图的地面上,纹理在两个三角形的公共对角线处明显“折断”,每个三角形内部的格子都朝同一方向歪斜。这正是 PS1 时代游戏的标志性瑕疵。注意右边那面斜墙:它几乎正对相机,深度变化很小,仿射插值的误差也就很小——误差大小取决于三角形内部 w(深度)的变化幅度。当年的游戏靠把大三角形细分成小三角形来缓解,就是这个原因。
noperspective 不只是用来怀旧。凡是本来就在屏幕空间里线性变化的量,用它插值才是“正确”的,下一个案例就是例子。其他修饰符还有 nointerpolation(不插值,整个三角形取第一个顶点的值,常用于传递整数 ID)、centroid(MSAA 下在覆盖区域的质心采样,防止采样点落在三角形外)等。
案例 1.5屏幕 UV:除法放在顶点还是片元进阶单独打开 ↗
目标:搞清楚为什么 URP 的 positionNDC(以及旧的 ComputeScreenPos)返回的是“没除 w”的值,必须在片元里再除。
原理:屏幕 UV 是 ,它在屏幕空间里是线性的。默认的透视校正插值会对插值量“除以 w 插值再乘回来”,对已经除过 w 的量再做一次透视校正,结果就错了。三种写法对比:
struct Varyings
{
    float4 positionCS  : SV_POSITION;
    float4 positionNDC : TEXCOORD0;                  // 齐次屏幕坐标 (x, y, z, w),xy 在 [0, w]
    float2 uvDivided   : TEXCOORD1;                  // 顶点里已经除过 w
    noperspective float2 uvDividedNP : TEXCOORD2;    // 同上,但按屏幕空间线性插值
};

Varyings vert(Attributes input)
{
    Varyings output;
    VertexPositionInputs pos = GetVertexPositionInputs(input.positionOS.xyz);
    output.positionCS  = pos.positionCS;
    output.positionNDC = pos.positionNDC;
    output.uvDivided   = pos.positionNDC.xy / pos.positionNDC.w;
    output.uvDividedNP = pos.positionNDC.xy / pos.positionNDC.w;
    return output;
}

float Checker(float2 uv)
{
    float aspect = _ScreenParams.x / _ScreenParams.y;
    float2 cell = floor(uv * float2(_Cells * aspect, _Cells));
    return fmod(abs(cell.x + cell.y), 2.0);
}

half4 frag(Varyings input) : SV_Target
{
    float2 uv;
    int mode = (int)_Mode;
    if (mode == 0)      uv = input.positionNDC.xy / input.positionNDC.w;   // 插值之后再除
    else if (mode == 1) uv = input.uvDivided;
    else if (mode == 2) uv = input.uvDividedNP;
    else                uv = GetNormalizedScreenSpaceUV(input.positionCS);

    float k = Checker(uv);
    half3 col = lerp(half3(0.92, 0.92, 0.94), half3(0.12, 0.42, 0.56), k);
    return half4(col, 1);
}
VARYING vec4 vPositionNDC;     // 齐次屏幕坐标 (x, y, z, w),xy 在 [0, w]
VARYING vec2 vUvDivided;       // 顶点里已经除过 w
VARYING vec2 vUvDividedNPw;    // 同上,但按屏幕空间线性插值(noperspective 的模拟:先乘 w)
VARYING float vClipW;

#ifdef VERTEX
void main()
{
    VertexPositionInputs pos = GetVertexPositionInputs(positionOS.xyz);
    gl_Position   = pos.positionCS;
    vPositionNDC  = pos.positionNDC;
    vUvDivided    = pos.positionNDC.xy / pos.positionNDC.w;
    vUvDividedNPw = pos.positionNDC.xy / pos.positionNDC.w * pos.positionCS.w;
    vClipW        = pos.positionCS.w;
}
#endif

#ifdef FRAGMENT
float Checker(vec2 uv)
{
    float aspect = _ScreenParams.x / _ScreenParams.y;
    vec2 cell = floor(uv * vec2(_Cells * aspect, _Cells));
    float s = abs(cell.x + cell.y);
    return s - 2.0 * trunc(s / 2.0);   // fmod(s, 2)
}

void main()
{
    vec2 uv;
    int mode = int(_Mode);
    if (mode == 0)      uv = vPositionNDC.xy / vPositionNDC.w;   // 插值之后再除
    else if (mode == 1) uv = vUvDivided;
    else if (mode == 2) uv = vUvDividedNPw / vClipW;
    else                uv = GetNormalizedScreenSpaceUV(gl_FragCoord);

    float k = Checker(uv);
    vec3 col = mix(vec3(0.92, 0.92, 0.94), vec3(0.12, 0.42, 0.56), k);
    fragColor = vec4(col, 1);
}
#endif
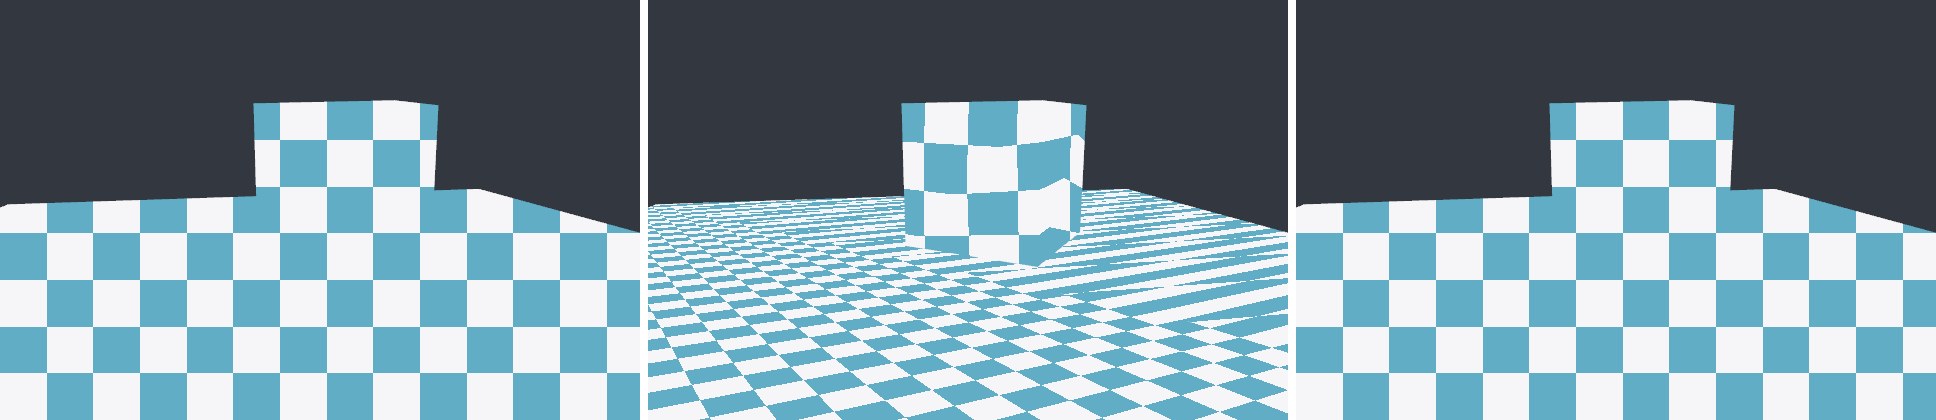
正确的屏幕空间棋盘格应该像一张贴在屏幕上的格子纸,和三维几何毫无关系(左、右)。中图的格子被几何“带歪了”:每个三角形内部的格子沿三角形发生了透视变形,地面两个三角形的交界处还能看到断裂。
为什么左图正确?透视校正插值对 positionNDC 的 xy 和 w 分别做正确的插值,片元里再相除,得到的就是这个像素真实的 x/w。为什么右图也正确?x/w 在屏幕空间本来就是线性的,noperspective 的屏幕空间线性插值恰好吻合。实践中最简单的写法是第四种:直接在片元里用 GetNormalizedScreenSpaceUV(input.positionCS),由像素坐标除以屏幕尺寸得到 UV,连 Varyings 都省了(Shader 里的 _Mode = 3,结果与左图相同)。
✓ 推荐
片元里GetNormalizedScreenSpaceUV(positionCS);或顶点输出 positionNDC、片元里 xy / w。✗ 避免
顶点里先做xy / w 再交给默认插值。小三角形上误差不明显,大三角形(地面、水面、天空)上会出现可见的扭曲。1.17 与 Built-in 管线的差异
如果你有 Built-in 管线的 Shader 经验,下面这张对照表能帮你快速迁移本章涉及的内容(完整的迁移表见附录 D):
| Built-in(UnityCG.cginc) | URP 14 | 说明 |
|---|---|---|
UnityObjectToClipPos(v) | TransformObjectToHClip(p) | 物体 → 裁剪空间 |
mul(unity_ObjectToWorld, v) | TransformObjectToWorld(p) | URP 版本返回 float3 |
UnityObjectToWorldNormal(n) | TransformObjectToWorldNormal(n) | 都乘逆转置 |
UnityObjectToViewPos(v) | TransformWorldToView(TransformObjectToWorld(p)) | 观察空间仍为右手系 |
ComputeScreenPos(cs) | GetVertexPositionInputs(p).positionNDC | URP 14 中前者已标记弃用 |
SAMPLE_DEPTH_TEXTURE(_CameraDepthTexture, uv) | SampleSceneDepth(uv) | 需 include DeclareDepthTexture.hlsl |
LinearEyeDepth(d)(单参数) | LinearEyeDepth(d, _ZBufferParams) | URP 版本需显式传参 |
相机深度纹理靠 Camera.depthTextureMode 开启 | URP Asset 的 Depth Texture 开关 | 见第 2 章 |
本章小结
- 渲染管线 = CPU 准备(剔除、排序、Draw Call)+ GPU 流水线(顶点着色 → 裁剪 → 透视除法 → 视口变换 → 光栅化插值 → 片元着色 → 逐片元操作)。
- 顶点着色器唯一的硬性任务是输出裁剪空间坐标
SV_POSITION;片元里的SV_POSITION已变成像素坐标。 - 裁剪在齐次空间里做;透视除法产生“近大远小”;属性插值默认透视校正,
noperspective可关闭。 - Early-Z 让被遮挡的片元跳过着色;
clip、写SV_Depth会妨碍它。移动 GPU 采用 TBDR,带宽与渲染目标切换是性能关键。 - 坐标空间链 Object → World → View → Clip → NDC → Screen;Unity 世界左手系、观察空间右手系(看向 −Z);透视投影下 clip.w 等于观察深度。
- 法线要乘模型矩阵的逆转置;原始深度是非线性的,Reversed-Z 平台近 1 远 0,用
Linear01Depth/LinearEyeDepth配合_ZBufferParams转换。 - 平台差异:
UNITY_REVERSED_Z、UNITY_UV_STARTS_AT_TOP、UNITY_NEAR_CLIP_VALUE、运行时的_ProjectionParams.x。
练习
- 在 SpaceViz 里增加一个模式:显示片元到相机的欧氏距离的等值线(用
distance和GetCameraPositionWS),与观察空间等深线对比,解释两者在画面边缘的差异。 - 把 DepthViz 改成“画中画”:只占屏幕右上角四分之一。提示:只需要改顶点着色器里的缩放和偏移,以及片元里 UV 的计算方式。
- 把相机改成正交投影,重新观察 ch01-depth 三种模式。哪一种显示变了?查看
LinearEyeDepth对正交相机是否适用,并找出 URP 中处理正交深度的函数(提示:LinearDepthToEyeDepth)。 - 在 NormalViz 中加入模式:用
ddx/ddy对positionWS求叉积得到“面法线”,与插值法线对比,看看球面上的差异。 - 阅读 core 包
Common.hlsl中的ComputeClipSpacePosition,解释为什么其中有一段#if UNITY_UV_STARTS_AT_TOP翻转 y 的代码。