经典光照模型
在“基于物理的渲染”成为默认选项的今天,Lambert 和 Blinn-Phong 仍然是每一个图形程序员的基本功:它们足够简单,可以一行一行推导;它们足够有用,移动端、风格化渲染和 URP 自带的 Simple Lit 至今都在用。本章从“光照到底在算什么”讲起,把漫反射与高光的每一种经典写法都在 URP 里亲手实现一遍。
5.1 光照模型在算什么
屏幕上每一个像素的颜色,本质上是在回答一个问题:从这个表面点出发、朝着相机方向射出的光有多少、是什么颜色。光从光源出发,打到表面后会发生三件事:一部分在表面被直接反射出去,一部分进入物体内部、在内部来回散射后再从表面附近射出,剩下的被吸收变成热。我们看到的“颜色”和“质感”,就是这几部分按不同比例混合的结果。
实时渲染里的“光照模型”就是对上面这个过程的近似公式。经典光照模型把它拆成三项相加:
- 环境光(Ambient):来自四面八方、被场景反复反弹过的光。经典模型里它是一个常数,URP 里通常用球谐光照(Spherical Harmonics,SH)近似,本章直接调用
SampleSH(normalWS),原理留到第 8 章。 - 漫反射(Diffuse):只和“光从哪来”有关、和“从哪看”无关。粉笔、陶土、未上漆的木头几乎只有漫反射。
- 镜面高光(Specular):光源在表面上的“倒影”,会随视角移动。塑料、漆面、金属的亮点都来自它。
这三项最早都是经验模型:公式的形状看起来对就行,不追究能量是否守恒、参数有没有物理意义。后面第三部分的 PBR 则是物理模型,每一项都从辐射度量学和微表面理论推出来。为什么在 PBR 时代还要花一章讲经验模型?原因有三个。第一,它们是 PBR 的“前身”:Lambert 就是 PBR 里的漫反射项,Blinn-Phong 的半程向量就是微表面理论的核心概念,学会它们再看 PBR 会顺畅得多。第二,它们便宜:低端移动设备、大量远景物体、风格化游戏,经常用 Blinn-Phong 而不是完整的 PBR,URP 自带的 Simple Lit Shader 本身就是 Blinn-Phong。第三,卡通渲染(第 14 章)、各种 NPR 效果,几乎都是在 Lambert 和 Half-Lambert 上“掰弯”出来的。
5.2 URP 中的光源数据:GetMainLight() 与 Light 结构体
写光照之前,先要拿到光源的数据。在 Built-in 管线里,我们用的是 _WorldSpaceLightPos0 和 _LightColor0 这两个全局变量;URP 把它们包装成了一个结构体和几个函数,定义在 ShaderLibrary/RealtimeLights.hlsl 里(它被 Lighting.hlsl 包含,所以平时只需要 include 后者):
struct Light
{
    half3   direction;
    half3   color;
    float   distanceAttenuation; // full-float precision required on some platforms
    half    shadowAttenuation;
    uint    layerMask;
};

Light GetMainLight()
{
    Light light;
    light.direction = half3(_MainLightPosition.xyz);
#if USE_FORWARD_PLUS
    ...
    light.distanceAttenuation = 1.0;
#else
    light.distanceAttenuation = unity_LightData.z; // 1 when not culled by the culling mask, otherwise 0.
#endif
    light.shadowAttenuation = 1.0;
    light.color = _MainLightColor.rgb;
    light.layerMask = _MainLightLayerMask;
    return light;
}
逐个字段看:
| 字段 | 含义与注意事项 |
|---|---|
direction | 世界空间的单位向量,从表面指向光源(与光线前进方向相反)。方向光的“位置”其实就是方向,所以 URP 把它存在 _MainLightPosition.xyz 里,w 分量为 0。 |
color | 灯光颜色 × Intensity,已经是线性空间的 HDR 值(工程使用 Linear 色彩空间时)。勾选了色温时,色温也已经乘进去。它可以大于 1。 |
distanceAttenuation | 距离衰减。方向光没有距离衰减,但在 Forward 路径下,这里放的是 unity_LightData.z:当这盏灯的 Culling Mask 不包含当前物体所在的 Layer 时为 0,否则为 1。所以即使是主光源也要乘上它,否则 Culling Mask 会失效。Forward+ 路径下它恒为 1(或与 Subtractive 光照贴图有关的值)。 |
shadowAttenuation | 阴影衰减,0 表示完全在阴影里。无参数的 GetMainLight() 不计算阴影,恒为 1;带 shadowCoord 的重载才会采样阴影图,见第 6 章。 |
layerMask | 灯光的渲染层(Rendering Layers),配合 Light Layers 功能使用,见第 6 章。 |
那么“主光源”是哪一盏?URP 每帧在 UniversalRenderPipeline.GetMainLightIndex() 里挑选:如果 指定了一盏可见的方向光,就用它;否则在所有可见的方向光里挑 Intensity 最大的那一盏。点光和聚光永远不会成为主光源,它们都是“附加光”。数据的流向可以画成下图:
有了 Light,所有经典光照模型的输入就齐了:表面法线 N、指向光源的 L(= light.direction)、指向相机的 V(= GetWorldSpaceNormalizeViewDir(positionWS)),以及入射光的颜色与强度。本书统一用这几个字母,而且所有方向向量都从表面点出发,这能避免大部分符号错误。
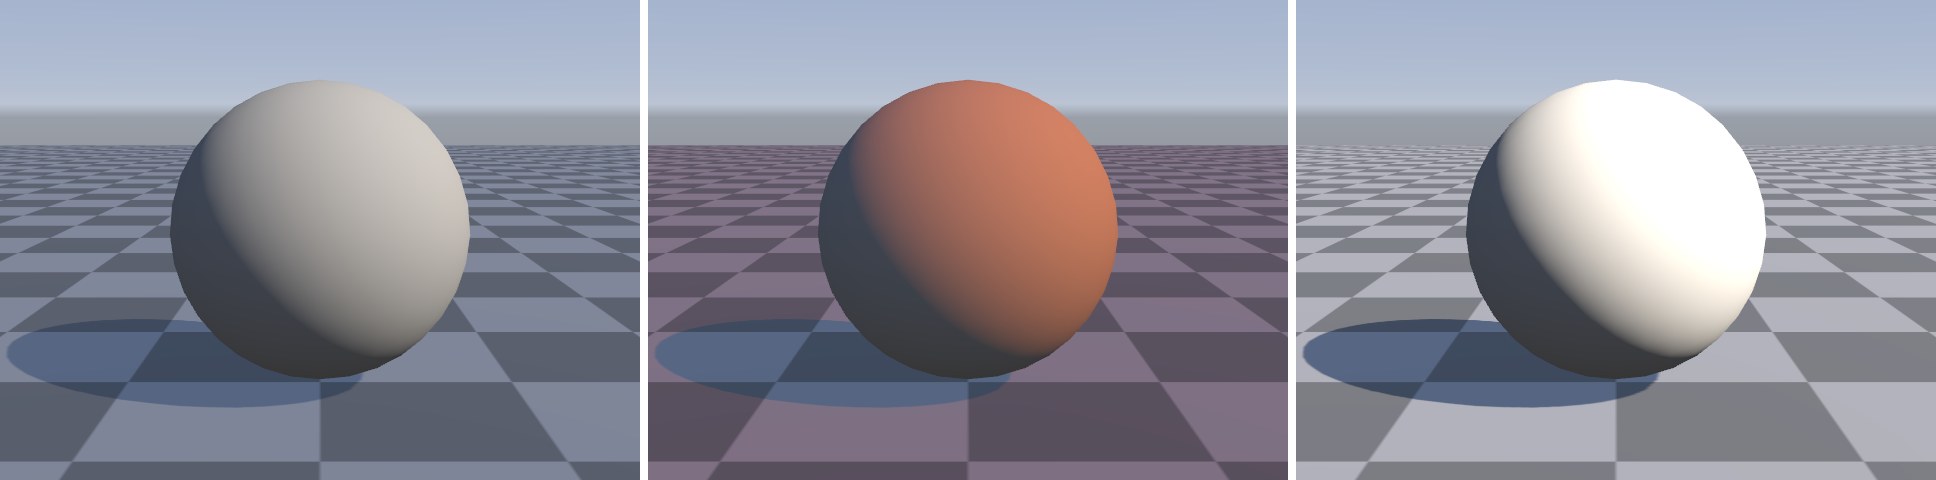
下面这组图用案例 5.1 的 Lambert Shader 渲染,只改了灯光组件:左边是白光、Intensity = 1;中间把颜色换成橙色;右边把 Intensity 提到 3。注意右图受光面直接“爆白”:本书的配图默认关闭了后处理,没有色调映射(Tone Mapping),所以大于 1 的颜色被直接截断。真实项目里应该开启 HDR 与 Tonemapping,这部分在第 9、27 章讨论。
案例 5.1Lambert 漫反射入门单独打开 ↗
目标:写出 URP 里最简单的“受光” Shader——主光源的 Lambert 漫反射加球谐环境光,并理解那个无处不在的 N·L 到底是怎么来的。
原理:余弦定律
想象一束截面积为 A 的平行光。光束正对表面时,它照亮的面积就是 A;表面倾斜 θ 角后,同一束光被摊在 A / cos θ 的面积上。光的总能量没变,摊开的面积变大了,单位面积接收到的能量(辐照度,Irradiance)就按 cos θ 下降。这就是 Lambert 余弦定律。而 cos θ 恰好等于单位法线与单位光照方向的点积 N·L。
一个理想的漫反射表面(Lambertian 表面)把接收到的光均匀地散射到上半球的所有方向,所以从任何角度看它的亮度都一样,只取决于它接收了多少光。物理上,它的 BRDF(双向反射分布函数,第 9 章细讲)是一个常数:
其中 ρ 是反照率(Albedo,也就是材质的“底色”,0~1),E⊥ 是光垂直入射时的辐照度。分母里的 π 来自“把能量均匀分到半球上”的积分,它保证漫反射出去的总能量不超过收到的能量。
Unity 里的 π 去哪了
如果你翻 URP 的 LightingLambert() 或 BRDF 代码,会发现漫反射写的是 albedo * lightColor * NdotL,没有除以 π。这不是错误,而是一个约定:Unity(以及多数游戏引擎)规定灯光的 Intensity 已经“预先乘了 π”,也就是说 light.color 代表的是 π·E⊥。这样美术把一盏 Intensity = 1 的白光照在白色表面上,正对的地方刚好输出 1,直观易调。代价是:凡是从论文里抄来的 BRDF 公式,都要整体乘以 π 才能和 Unity 的灯光配合。这一点在本章的高光归一化和第 9~11 章的 PBR 里会反复出现。
完整代码
// 案例 5.1 Lambert 漫反射:只计算主光源的 N·L,再加一点球谐环境光
Shader "Cookbook/Ch05/Lambert"
{
    Properties
    {
        [MainColor] _BaseColor("Base Color", Color) = (0.85, 0.5, 0.25, 1)
        _AmbientStrength("Ambient Strength", Range(0, 1)) = 1
    }

    SubShader
    {
        Tags { "RenderType"="Opaque" "RenderPipeline"="UniversalPipeline" "Queue"="Geometry" }

        HLSLINCLUDE
        #include "Packages/com.unity.render-pipelines.universal/ShaderLibrary/Core.hlsl"

        CBUFFER_START(UnityPerMaterial)
            half4 _BaseColor;
            half  _AmbientStrength;
        CBUFFER_END
        ENDHLSL

        Pass
        {
            Name "ForwardLit"
            Tags { "LightMode"="UniversalForward" }

            HLSLPROGRAM
            #pragma vertex vert
            #pragma fragment frag
            #include "Packages/com.unity.render-pipelines.universal/ShaderLibrary/Lighting.hlsl"

            struct Attributes
            {
                float4 positionOS : POSITION;
                float3 normalOS   : NORMAL;
            };

            struct Varyings
            {
                float4 positionCS : SV_POSITION;
                float3 normalWS   : TEXCOORD0;
            };

            Varyings vert(Attributes input)
            {
                Varyings output;
                output.positionCS = TransformObjectToHClip(input.positionOS.xyz);
                // 法线要用“逆转置矩阵”变换,TransformObjectToWorldNormal 已经处理了非等比缩放
                output.normalWS = TransformObjectToWorldNormal(input.normalOS);
                return output;
            }

            half4 frag(Varyings input) : SV_Target
            {
                // 插值后的法线长度不再是 1,必须重新归一化
                half3 N = normalize(input.normalWS);

                Light mainLight = GetMainLight();
                // direction 指向光源;color 已经乘过 Intensity,是线性空间的 HDR 值
                half3 radiance = mainLight.color * mainLight.distanceAttenuation;

                // 余弦定律:背光面 N·L < 0,必须截断到 0,否则会“吸收”别的光
                half NdotL = saturate(dot(N, mainLight.direction));
                half3 diffuse = _BaseColor.rgb * radiance * NdotL;

                // 环境光:来自天空的球谐光照,第 8 章细讲。没有它,背光面会是纯黑
                half3 ambient = _BaseColor.rgb * SampleSH(N) * _AmbientStrength;

                return half4(diffuse + ambient, 1);
            }
            ENDHLSL
        }

        // ---- 投影与深度:本章先照抄,原理见第 6 章 ----
        Pass
        {
            Name "ShadowCaster"
            Tags { "LightMode"="ShadowCaster" }
            ZWrite On
            ZTest LEqual
            ColorMask 0

            HLSLPROGRAM
            #pragma vertex ShadowDepthVert
            #pragma fragment ShadowDepthFrag
            #pragma multi_compile_vertex _ _CASTING_PUNCTUAL_LIGHT_SHADOW
            #include "Assets/Cookbook/Ch05/Ch05ShadowDepth.hlsl"
            ENDHLSL
        }

        Pass
        {
            Name "DepthOnly"
            Tags { "LightMode"="DepthOnly" }
            ZWrite On
            ColorMask R

            HLSLPROGRAM
            #pragma vertex DepthOnlyVert
            #pragma fragment DepthOnlyFrag
            #include "Assets/Cookbook/Ch05/Ch05ShadowDepth.hlsl"
            ENDHLSL
        }
    }
}
// 案例 5.1 Lambert 漫反射:只计算主光源的 N·L,再加一点球谐环境光(GLSL 版,对应 Ch05/Lambert.shader)
Shader "Cookbook/Ch05/Lambert"
{
    SubShader
    {
        Tags { "RenderType"="Opaque" "Queue"="Geometry" }

        GLSLINCLUDE
        uniform vec4  _BaseColor;
        uniform float _AmbientStrength;
        ENDGLSL

        Pass
        {
            Name "ForwardLit"
            Tags { "LightMode"="UniversalForward" }

            GLSLPROGRAM
            VARYING vec3 normalWS;

            #ifdef VERTEX
            void main()
            {
                gl_Position = TransformObjectToHClip(positionOS.xyz);
                // 法线要用“逆转置矩阵”变换,TransformObjectToWorldNormal 已经处理了非等比缩放
                normalWS = TransformObjectToWorldNormal(normalOS);
            }
            #endif

            #ifdef FRAGMENT
            void main()
            {
                // 插值后的法线长度不再是 1,必须重新归一化
                vec3 N = normalize(normalWS);

                Light mainLight = GetMainLight();
                // direction 指向光源;color 已经乘过 Intensity,是线性空间的 HDR 值
                vec3 radiance = mainLight.color * mainLight.distanceAttenuation;

                // 余弦定律:背光面 N·L < 0,必须截断到 0,否则会“吸收”别的光
                float NdotL = saturate(dot(N, mainLight.direction));
                vec3 diffuse = _BaseColor.rgb * radiance * NdotL;

                // 环境光:来自天空的球谐光照,第 8 章细讲。没有它,背光面会是纯黑
                vec3 ambient = _BaseColor.rgb * SampleSH(N) * _AmbientStrength;

                fragColor = vec4(diffuse + ambient, 1.0);
            }
            #endif
            ENDGLSL
        }

        // ---- 投影与深度:本章先照抄,原理见第 6 章 ----
        Pass
        {
            Name "ShadowCaster"
            Tags { "LightMode"="ShadowCaster" }
            ZWrite On
            ZTest LEqual
            ColorMask 0
            GLSLPROGRAM
            #define SHADOW_PASS
            #include "Ch05/Ch05ShadowDepth.glsl"
            ENDGLSL
        }

        Pass
        {
            Name "DepthOnly"
            Tags { "LightMode"="DepthOnly" }
            ZWrite On
            ColorMask R
            GLSLPROGRAM
            #define DEPTH_PASS
            #include "Ch05/Ch05ShadowDepth.glsl"
            ENDGLSL
        }
    }
}
关键代码讲解
half4 frag(Varyings input) : SV_Target
{
    // 插值后的法线长度不再是 1,必须重新归一化
    half3 N = normalize(input.normalWS);

    Light mainLight = GetMainLight();
    // direction 指向光源;color 已经乘过 Intensity,是线性空间的 HDR 值
    half3 radiance = mainLight.color * mainLight.distanceAttenuation;

    // 余弦定律:背光面 N·L < 0,必须截断到 0,否则会“吸收”别的光
    half NdotL = saturate(dot(N, mainLight.direction));
    half3 diffuse = _BaseColor.rgb * radiance * NdotL;

    // 环境光:来自天空的球谐光照,第 8 章细讲。没有它,背光面会是纯黑
    half3 ambient = _BaseColor.rgb * SampleSH(N) * _AmbientStrength;

    return half4(diffuse + ambient, 1);
}
// 案例 5.1 Lambert 漫反射:只计算主光源的 N·L,再加一点球谐环境光(GLSL 版,对应 Ch05/Lambert.shader)
Shader "Cookbook/Ch05/Lambert"
{
    SubShader
    {
        Tags { "RenderType"="Opaque" "Queue"="Geometry" }

        GLSLINCLUDE
        uniform vec4  _BaseColor;
        uniform float _AmbientStrength;
        ENDGLSL

        Pass
        {
            Name "ForwardLit"
            Tags { "LightMode"="UniversalForward" }

            GLSLPROGRAM
            VARYING vec3 normalWS;

            #ifdef VERTEX
            void main()
            {
                gl_Position = TransformObjectToHClip(positionOS.xyz);
                // 法线要用“逆转置矩阵”变换,TransformObjectToWorldNormal 已经处理了非等比缩放
                normalWS = TransformObjectToWorldNormal(normalOS);
            }
            #endif

            #ifdef FRAGMENT
            void main()
            {
                // 插值后的法线长度不再是 1,必须重新归一化
                vec3 N = normalize(normalWS);

                Light mainLight = GetMainLight();
                // direction 指向光源;color 已经乘过 Intensity,是线性空间的 HDR 值
                vec3 radiance = mainLight.color * mainLight.distanceAttenuation;

                // 余弦定律:背光面 N·L < 0,必须截断到 0,否则会“吸收”别的光
                float NdotL = saturate(dot(N, mainLight.direction));
                vec3 diffuse = _BaseColor.rgb * radiance * NdotL;

                // 环境光:来自天空的球谐光照,第 8 章细讲。没有它,背光面会是纯黑
                vec3 ambient = _BaseColor.rgb * SampleSH(N) * _AmbientStrength;

                fragColor = vec4(diffuse + ambient, 1.0);
            }
            #endif
            ENDGLSL
        }

        // ---- 投影与深度:本章先照抄,原理见第 6 章 ----
        Pass
        {
            Name "ShadowCaster"
            Tags { "LightMode"="ShadowCaster" }
            ZWrite On
            ZTest LEqual
            ColorMask 0
            GLSLPROGRAM
            #define SHADOW_PASS
            #include "Ch05/Ch05ShadowDepth.glsl"
            ENDGLSL
        }

        Pass
        {
            Name "DepthOnly"
            Tags { "LightMode"="DepthOnly" }
            ZWrite On
            ColorMask R
            GLSLPROGRAM
            #define DEPTH_PASS
            #include "Ch05/Ch05ShadowDepth.glsl"
            ENDGLSL
        }
    }
}
- 重新归一化法线。顶点法线在光栅化时被线性插值,两个单位向量的线性插值长度小于 1(在两向量夹角越大时越明显),不归一化的话三角形中间会偏暗。这一行在低模上尤其重要。
- radiance = color × distanceAttenuation。如 5.2 节所说,主光源也要乘
distanceAttenuation,否则灯光的 Culling Mask 在 Forward 路径下失效。 - saturate(dot(N, L))。背光面 N·L 为负,物理上意味着“光从背面来”,表面接收不到它,必须截断为 0。如果忘了截断,负值会把环境光也“减掉”,背光面会比纯环境光还暗,甚至出现负颜色。
saturate等价于clamp(x, 0, 1),在大多数 GPU 上是免费的指令修饰符,比max(0, x)更推荐。 - 环境光。
SampleSH(N)返回法线方向上的环境辐照度(来自天空盒烘焙出的球谐系数),乘上反照率就是最简单的环境漫反射。把_AmbientStrength设为 0,背光面就会变成纯黑。
顶点着色器里用 TransformObjectToWorldNormal 而不是 TransformObjectToWorld 变换法线:法线必须用模型矩阵的逆转置来变换,才能在非等比缩放时保持与表面垂直。这个函数内部用的是 unity_WorldToObject 的转置,并默认做了归一化。
Shader 末尾的两个 Pass 来自 Ch05ShadowDepth.hlsl,它们让物体能把影子投到地面上、能被写进深度图。注意文件开头那一行额外的 include:
// 第 5 章所有 Shader 共用的 ShadowCaster / DepthOnly 顶点与片元函数。
// 本章只关心“表面怎么被照亮”,这两个 Pass 只负责让物体能投影、能写进深度图,
// 它们的原理(ApplyShadowBias、_CASTING_PUNCTUAL_LIGHT_SHADOW 等)在第 6 章细讲。
#ifndef COOKBOOK_CH05_SHADOW_DEPTH_INCLUDED
#define COOKBOOK_CH05_SHADOW_DEPTH_INCLUDED

#include "Packages/com.unity.render-pipelines.universal/ShaderLibrary/Core.hlsl"
// Shadows.hlsl 用到了 LerpWhiteTo(),它定义在 CommonMaterial.hlsl 里,但 Shadows.hlsl 自己没有 include。
// URP 自带的 Lit 之所以不报错,是因为 LitInput.hlsl 先 include 了它。自己写 ShadowCaster 时要补上。
#include "Packages/com.unity.render-pipelines.core/ShaderLibrary/CommonMaterial.hlsl"
#include "Packages/com.unity.render-pipelines.universal/ShaderLibrary/Shadows.hlsl"

// 由 URP 的阴影 Pass 在绘制每个投射光源前设置
float3 _LightDirection;
float3 _LightPosition;
// 第 5 章所有 Shader 共用的 ShadowCaster / DepthOnly 顶点与片元代码(GLSL 版)。
// 原理(ApplyShadowBias、点光源投影等)在第 6 章细讲。
// 用法:在 Pass 的 GLSLPROGRAM 里先 #define SHADOW_PASS 或 DEPTH_PASS,再 #include 本文件。

#ifdef SHADOW_PASS
#ifdef VERTEX
void main()
{
    vec3 positionWS = TransformObjectToWorld(positionOS.xyz);
    vec3 normalWS = TransformObjectToWorldNormal(normalOS);
    // 点光源/聚光灯:方向从顶点指向灯;方向光:所有顶点同一方向(_CASTING_PUNCTUAL_LIGHT_SHADOW 在 GLSL 版里是个 uniform)
    vec3 lightDirectionWS = _CastingPunctualLightShadow > 0.5 ? normalize(_LightPosition - positionWS) : _LightDirection;
    vec4 positionCS = TransformWorldToHClip(ApplyShadowBias(positionWS, normalWS, lightDirectionWS));
    positionCS.z = max(positionCS.z, UNITY_NEAR_CLIP_VALUE * positionCS.w);
    gl_Position = positionCS;
}
#endif
#ifdef FRAGMENT
void main() { fragColor = vec4(0.0); }   // ColorMask 0,只写深度
#endif
#endif

#ifdef DEPTH_PASS
#ifdef VERTEX
void main() { gl_Position = TransformObjectToHClip(positionOS.xyz); }
#endif
#ifdef FRAGMENT
void main() { fragColor = vec4(gl_FragCoord.z); }   // 与 URP DepthOnlyPass 一致:深度写进 R 通道
#endif
#endif
Shadows.hlsl 会编译失败,报 undeclared identifier 'LerpWhiteTo'。这个函数在 Core RP 的 CommonMaterial.hlsl 里,而 Shadows.hlsl 没有包含它。URP 的 Lit 不报错,只是因为 LitInput.hlsl 恰好先 include 了它。效果
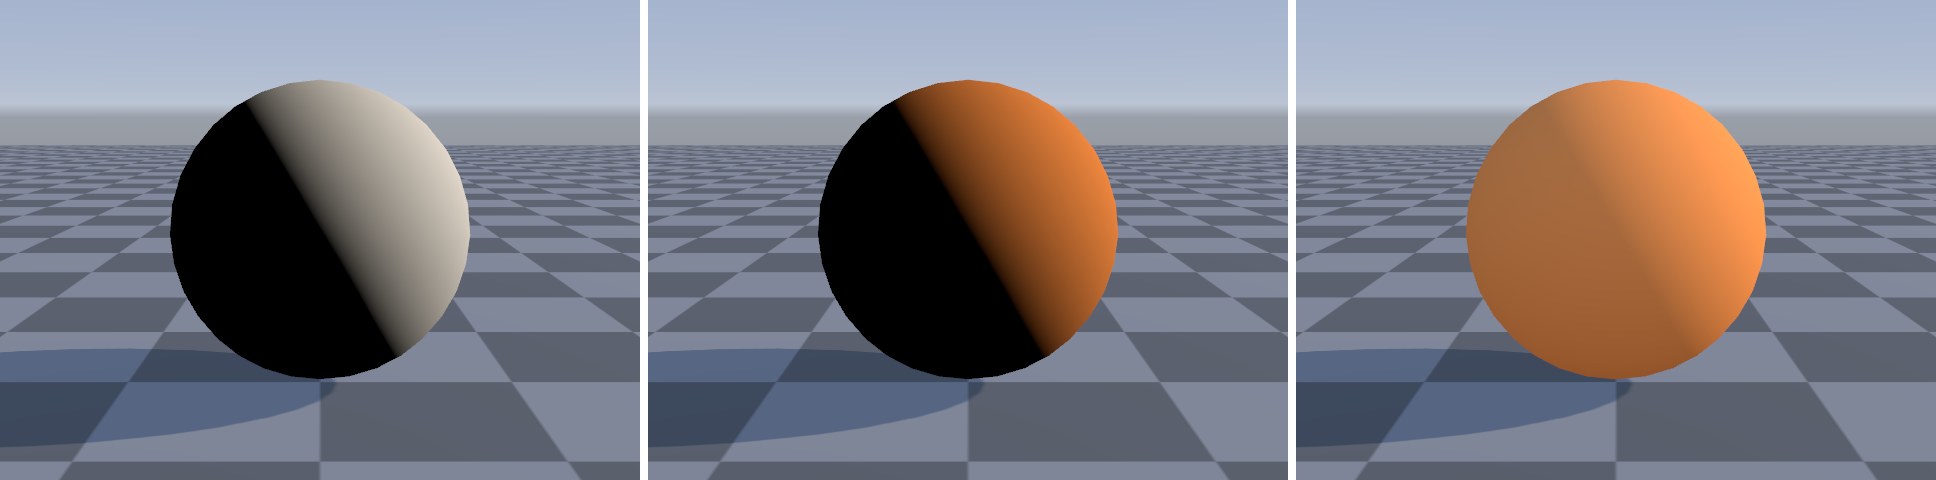
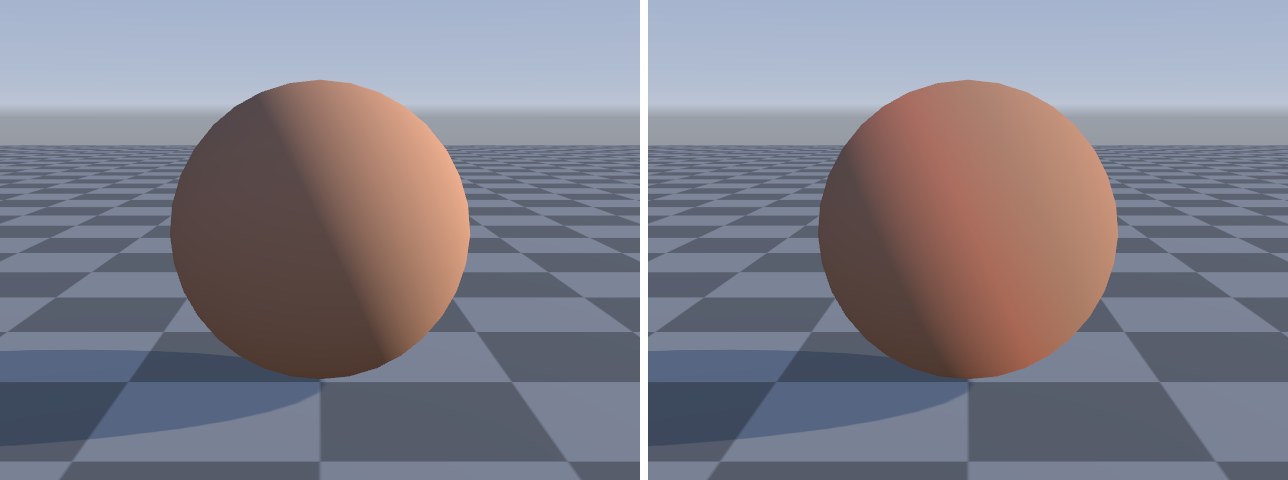
左图就是 N·L 本身的可视化:受光最强的点正对光源,越往边缘越暗,交界线处降到 0。中图的硬交界线和纯黑的背光面,是“只有直接光”的典型样子,在太空场景之外很少见。右图加了环境光以后,背光面有了来自天空的蓝色调,整体立刻可信多了,但也因此显得平——这正是下面几个案例要解决的问题。
案例 5.2Half-Lambert:让暗部不再死黑入门单独打开 ↗
目标:理解 Valve 在《半条命 2》中提出的 Half-Lambert 光照,用它让角色背光面保留形体。
原理
Lambert 的问题在于:从交界线开始,整个背光的半球都是同一个值 0。没有环境光时背光面一片死黑;即使有环境光,背光面也只剩下环境光那一点点起伏,形体信息丢失严重。Valve 的做法非常直接:不截断 N·L,而是把它的取值范围 [−1, 1] 线性地映射到 [0, 1],再取平方:
映射以后,正对光源仍是 1,交界线处变成 0.5(平方后 0.25),只有正背面才是 0。背光面从“一片 0”变成了一个平滑的渐变,形体就回来了。平方的作用是把整体拉暗一点、让亮暗过渡更接近 Lambert 的观感,否则映射后的结果会显得发灰、发平。下图把几种漫反射曲线画在一起,横轴是法线与光线的夹角 θ。
代码
Half-Lambert 的 Shader 只有片元函数和 Lambert 不同,这里只列出这一段:
half4 frag(Varyings input) : SV_Target
{
    half3 N = normalize(input.normalWS);
    Light mainLight = GetMainLight();
    half3 radiance = mainLight.color * mainLight.distanceAttenuation;

    // 注意这里没有 saturate:背光面的负值也要参与映射
    half NdotL = dot(N, mainLight.direction);
    half halfLambert = NdotL * 0.5 + 0.5;          // [-1,1] -> [0,1]
    halfLambert = pow(halfLambert, _Power);         // Valve 原版取平方,让暗部重新“沉下去”

    half3 diffuse = _BaseColor.rgb * radiance * halfLambert;
    half3 ambient = _BaseColor.rgb * SampleSH(N) * _AmbientStrength;
    return half4(diffuse + ambient, 1);
}
void main()
{
    vec3 N = normalize(normalWS);
    Light mainLight = GetMainLight();
    vec3 radiance = mainLight.color * mainLight.distanceAttenuation;

    // 注意这里没有 saturate:背光面的负值也要参与映射
    float NdotL = dot(N, mainLight.direction);
    float halfLambert = NdotL * 0.5 + 0.5;          // [-1,1] -> [0,1]
    halfLambert = pow(halfLambert, _Power);         // Valve 原版取平方,让暗部重新“沉下去”

    vec3 diffuse = _BaseColor.rgb * radiance * halfLambert;
    vec3 ambient = _BaseColor.rgb * SampleSH(N) * _AmbientStrength;
    fragColor = vec4(diffuse + ambient, 1.0);
}
和 Lambert 的唯一区别是:先映射再截断,所以 dot 的结果不能 saturate。_Power 设为 1 是不平方的版本,设为 2 是 Valve 原版。
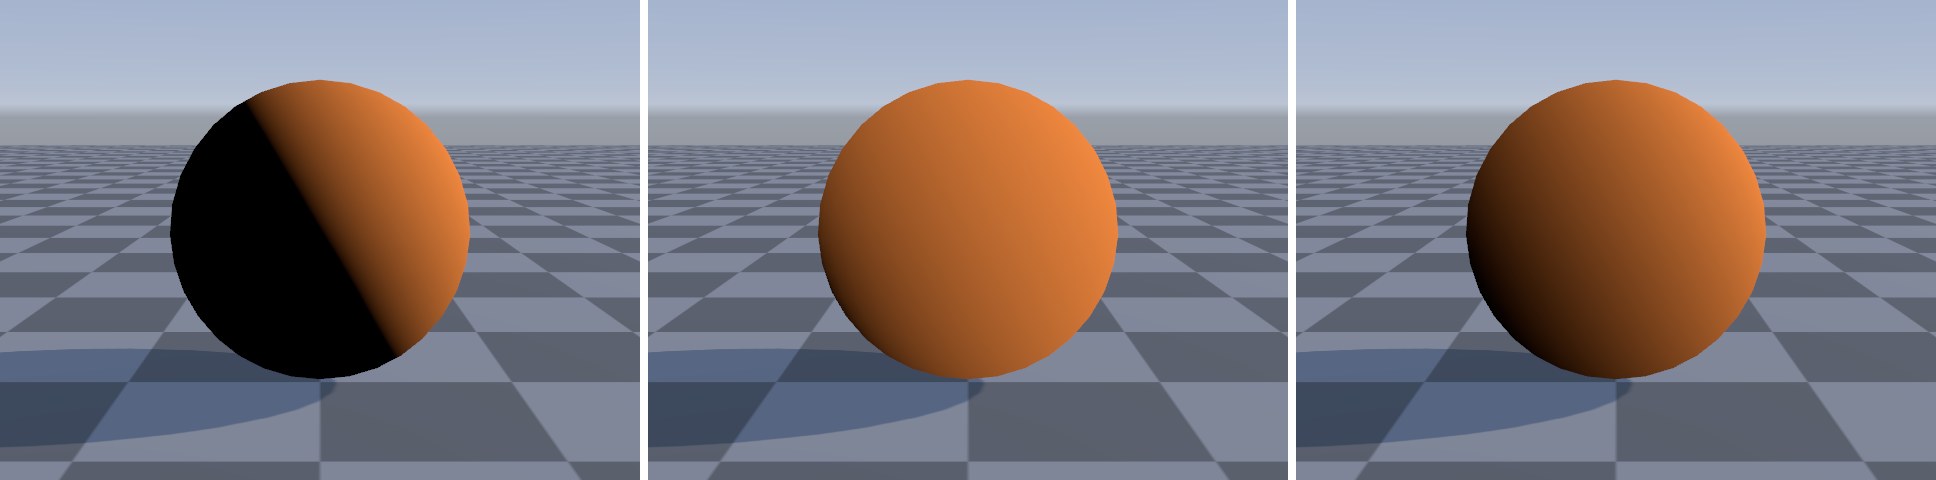
Half-Lambert 在物理上没有依据:它让背光面也“收到”了光,能量凭空多出来一截。它真正模拟的,是“环境里还有很多来自背后的反弹光”这件事——在没有像样的全局光照的年代,这是一个便宜又好看的折中。今天它主要用于:
- 卡通渲染:用 Half-Lambert 的结果去查一张色阶 Ramp 图,交界线的位置和宽度更好控制(第 14 章)。
- 没有烘焙光照的移动端场景:环境光太平、背光面太暗时,用它“提亮”角色。
- 毛发、布料等需要柔和明暗过渡的材质。
案例 5.3Wrap Lighting 与交界线染色进阶单独打开 ↗
目标:用一个参数在 Lambert 和 Half-Lambert 之间连续过渡,并给出“能量守恒”版本;再利用 Wrap 多出来的那一圈,给交界线染上颜色,做出廉价的次表面散射感。
原理
Wrap Lighting 让光“绕过”交界线,照亮背光面的一部分。参数 w(0~1)表示绕过去多远:
w = 0 时就是 Lambert;w = 1 时就是不平方的 Half-Lambert;中间的值让归零点落在 θ = arccos(−w) 处,比如 w = 0.5 时,光一直照到 120°。
这个式子有一个不太显眼的问题:它让表面变亮了。被照亮的区域变大,而峰值(正对光源处)仍然是 1,球体反射出去的总能量就比 Lambert 多。可以算一下:设 μ = cos θ,一个被平行光照射的球,反射的总能量正比于 D(μ) 在 μ ∈ [−1, 1] 上的积分。Lambert 是 ∫01 μ dμ = 1/2;Wrap 是 ∫−w1 (μ + w)/(1 + w) dμ = (1 + w)/2,多出了 (1 + w) 倍。所以只要把分母再乘一个 (1 + w),总能量就和 Lambert 相同了:
能量守恒版本的效果是:光“铺开”了,但峰值被压低,整体亮度不变。图 5-6 里橙色的曲线是不守恒的 w = 0.5 版本。
代码
half WrapDiffuse(half NdotL, half w)
{
#if defined(_WRAP_ENERGY_CONSERVING)
    // 分母 (1+w)^2:被照亮的范围变大了,峰值相应压低,总能量与 Lambert 相同
    return saturate((NdotL + w) / ((1 + w) * (1 + w)));
#else
    // 经典写法:w = 0 时退化为 Lambert,w = 1 时等价于未平方的 Half-Lambert
    return saturate((NdotL + w) / (1 + w));
#endif
}
half4 frag(Varyings input) : SV_Target
{
    half3 N = normalize(input.normalWS);
    Light mainLight = GetMainLight();
    half3 radiance = mainLight.color * mainLight.distanceAttenuation;

    half NdotL = dot(N, mainLight.direction);
    half wrap = WrapDiffuse(NdotL, _Wrap);

    // 交界线染色:只在“Wrap 有、Lambert 没有”的那一圈加颜色,模拟光在皮下散射后带出的红色
    half scatter = saturate(wrap - saturate(NdotL));
    half3 diffuse = _BaseColor.rgb * radiance * wrap
                  + _TerminatorTint.rgb * radiance * scatter;

    half3 ambient = _BaseColor.rgb * SampleSH(N) * _AmbientStrength;
    return half4(diffuse + ambient, 1);
}
void main()
{
    vec3 N = normalize(normalWS);
    Light mainLight = GetMainLight();
    vec3 radiance = mainLight.color * mainLight.distanceAttenuation;

    float NdotL = dot(N, mainLight.direction);
    float wrap = WrapDiffuse(NdotL, _Wrap);

    // 交界线染色:只在“Wrap 有、Lambert 没有”的那一圈加颜色,模拟光在皮下散射后带出的红色
    float scatter = saturate(wrap - saturate(NdotL));
    vec3 diffuse = _BaseColor.rgb * radiance * wrap
                 + _TerminatorTint.rgb * radiance * scatter;

    vec3 ambient = _BaseColor.rgb * SampleSH(N) * _AmbientStrength;
    fragColor = vec4(diffuse + ambient, 1.0);
}
能量守恒用 shader_feature_local_fragment 做成材质开关,两种写法编译成两个变体,运行时没有分支开销。交界线染色的思路是:wrap − saturate(NdotL) 恰好只在“Wrap 照亮了、Lambert 没照亮”的那一圈大于 0,用它乘上一个偏红的颜色叠加上去,就能模拟光在皮肤、蜡、玉石内部散射后从交界线附近透出的红晕。
案例 5.4Phong 高光入门单独打开 ↗
目标:实现 Bui Tuong Phong 在 1975 年提出的高光模型,理解反射向量、高光指数和它们的几何意义。
原理
镜子会把光沿着“镜面反射方向”反射出去:入射角等于反射角,入射光、法线和反射光在同一平面内。完美镜面只在恰好对准反射方向时才看得到光源,而真实表面不是完美光滑的,反射光会在反射方向周围散开一点。Phong 用一个经验公式描述这个“散开”:视线 V 越接近反射方向 R,高光越亮,亮度按 (R·V)n 衰减:
ks 是高光颜色(强度),n 是高光指数(Shininess)。n 越大,(R·V)n 从 1 掉到 0 的速度越快,高光就越小、越“硬”,表面看起来越光滑。反射向量的公式可以从下图直接读出来:把 L 投影到 N 上得到 (N·L)N,L 关于法线的镜像就是两倍投影减去 L 本身。
代码
half4 frag(Varyings input) : SV_Target
{
    float3 N = normalize(input.normalWS);
    float3 V = GetWorldSpaceNormalizeViewDir(input.positionWS);   // 指向相机
    Light mainLight = GetMainLight();
    float3 L = mainLight.direction;                                // 指向光源
    half3 radiance = mainLight.color * mainLight.distanceAttenuation;

    float NdotL = dot(N, L);
    half3 diffuse = _BaseColor.rgb * saturate(NdotL);

    // reflect(i, n) 要求 i 是“射入”方向,所以传 -L
    float3 R = reflect(-L, N);
    float RdotV = saturate(dot(R, V));
    // 高光指数常常上百,用 float 计算,避免 half 精度下出现色带
    float spec = pow(RdotV, _Shininess);
    // 背光面不应该出现高光(R 可能恰好朝向相机)
    spec *= step(0.0, NdotL);

    half3 color = (diffuse + _SpecColor.rgb * spec) * radiance;
    color += _BaseColor.rgb * SampleSH(N) * _AmbientStrength;
    return half4(color, 1);
}
void main()
{
    vec3 N = normalize(normalWS);
    vec3 V = GetWorldSpaceNormalizeViewDir(positionWS);   // 指向相机
    Light mainLight = GetMainLight();
    vec3 L = mainLight.direction;                         // 指向光源
    vec3 radiance = mainLight.color * mainLight.distanceAttenuation;

    float NdotL = dot(N, L);
    vec3 diffuse = _BaseColor.rgb * saturate(NdotL);

    // reflect(i, n) 要求 i 是“射入”方向,所以传 -L
    vec3 R = reflect(-L, N);
    float RdotV = saturate(dot(R, V));
    // 高光指数常常上百,用 float 计算,避免 half 精度下出现色带
    float spec = pow(RdotV, _Shininess);
    // 背光面不应该出现高光(R 可能恰好朝向相机)
    spec *= step(0.0, NdotL);

    vec3 color = (diffuse + _SpecColor.rgb * spec) * radiance;
    color += _BaseColor.rgb * SampleSH(N) * _AmbientStrength;
    fragColor = vec4(color, 1.0);
}
- reflect 的第一个参数是“入射方向”。HLSL 的
reflect(i, n)计算的是i − 2·dot(i, n)·n,i 指向表面。我们的 L 指向光源,所以要传-L。这是新手最常见的错误之一,写反了高光会出现在完全错误的位置。 - 背光面屏蔽。当 N·L < 0 时,光其实照不到这个点,但 R 依然可以算出来,而且可能恰好朝向相机,于是背光面会冒出一个“幽灵高光”。乘以
step(0, NdotL)把它关掉。 - 精度。高光指数动辄上百,
pow在 half 精度下很容易在高光边缘产生色带甚至溢出。本书在高光计算上统一使用 float,移动端如果要省寄存器,至少保证pow的底数是 float。 - 颜色组合。漫反射乘反照率,高光乘高光颜色,两者相加后再整体乘以入射光。高光颜色对电介质(塑料、漆、木头)应该是灰白色,因为它们的反射不“染色”。
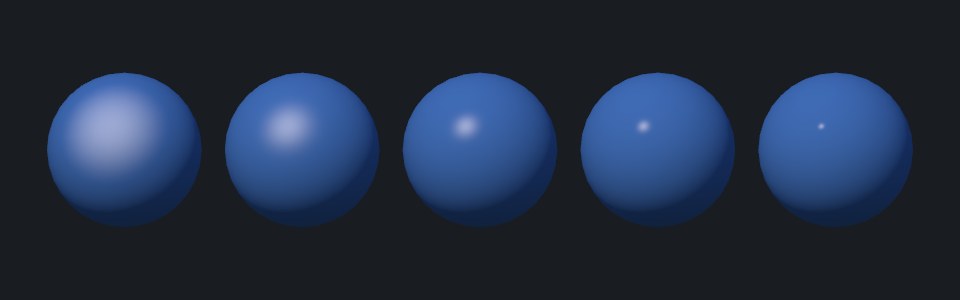
注意 Phong 模型在 V 与 R 夹角超过 90° 时 R·V 变为负数,被截断成 0,所以高光的“外沿”在 α = 90° 处被一刀切掉。在高光指数很小(n < 4)时,这条切边会在低角度的大平面上显现出来;n 稍大时 cosnα 早已接近 0,看不出来。
案例 5.5Blinn-Phong 与半程向量入门单独打开 ↗
目标:用半程向量 H 改写 Phong 高光,理解 Blinn-Phong 与 Phong 的形状差异,以及它为什么成了游戏引擎里的“标准高光”。
原理
Jim Blinn 在 1977 年提出:与其比较 R 和 V,不如比较 N 和“L 与 V 的角平分线”。这条角平分线就是半程向量(Half Vector):
当视线恰好在镜面反射方向上(V = R)时,L 和 V 关于 N 对称,它们的角平分线正好就是 N,N·H = 1,高光最亮——与 Phong 一致。偏离反射方向时,N 与 H 的夹角 β 大约只有 R 与 V 夹角 α 的一半,所以要得到差不多大小的高光,Blinn-Phong 的指数 n′ 要比 Phong 大,经验上 n′ ≈ 4n。
Blinn 当年的动机是性能:对于方向光和“无限远”的观察者,L 和 V 处处相同,H 也就是常数,每个像素只需要一次点积。今天这个优势在透视相机下已不存在,但 Blinn-Phong 依然被广泛使用,原因更深一层:H 有清晰的物理含义。把粗糙表面看成无数朝向各异的微小镜面,只有朝向恰好等于 H 的那些微镜面,才能把 L 方向来的光反射到 V 方向上。(N·H)n 描述的其实就是“朝向为 H 的微镜面有多少”,这正是第 9 章微表面理论里“法线分布函数 D”的雏形,Blinn-Phong NDF 至今仍是 PBR 文献里的一种 D 项。
代码
half4 frag(Varyings input) : SV_Target
{
    float3 N = normalize(input.normalWS);
    float3 V = GetWorldSpaceNormalizeViewDir(input.positionWS);
    Light mainLight = GetMainLight();
    float3 L = mainLight.direction;
    half3 radiance = mainLight.color * mainLight.distanceAttenuation;

    float NdotL = dot(N, L);
    half3 diffuse = _BaseColor.rgb * saturate(NdotL);

    // 半程向量:L 与 V 的“角平分线”。L、V 几乎相反时 L+V 接近零向量,用 SafeNormalize 防 NaN
    float3 H = SafeNormalize(L + V);
    float NdotH = saturate(dot(N, H));
    float spec = pow(NdotH, _Shininess) * step(0.0, NdotL);

    half3 color = (diffuse + _SpecColor.rgb * spec) * radiance;
    color += _BaseColor.rgb * SampleSH(N) * _AmbientStrength;
    return half4(color, 1);
}
void main()
{
    vec3 N = normalize(normalWS);
    vec3 V = GetWorldSpaceNormalizeViewDir(positionWS);
    Light mainLight = GetMainLight();
    vec3 L = mainLight.direction;
    vec3 radiance = mainLight.color * mainLight.distanceAttenuation;

    float NdotL = dot(N, L);
    vec3 diffuse = _BaseColor.rgb * saturate(NdotL);

    // 半程向量:L 与 V 的“角平分线”。L、V 几乎相反时 L+V 接近零向量,用 SafeNormalize 防 NaN
    vec3 H = SafeNormalize(L + V);
    float NdotH = saturate(dot(N, H));
    float spec = pow(NdotH, _Shininess) * step(0.0, NdotL);

    vec3 color = (diffuse + _SpecColor.rgb * spec) * radiance;
    color += _BaseColor.rgb * SampleSH(N) * _AmbientStrength;
    fragColor = vec4(color, 1.0);
}
和 Phong 相比只改了两行:用 SafeNormalize(L + V) 求 H,用 N·H 代替 R·V。SafeNormalize 在向量长度接近 0 时返回零向量而不是 NaN——当光从正背后照来、L 与 V 几乎相反时,L + V 会接近零向量,普通的 normalize 会除以 0。
Phong 与 Blinn-Phong 的形状差异
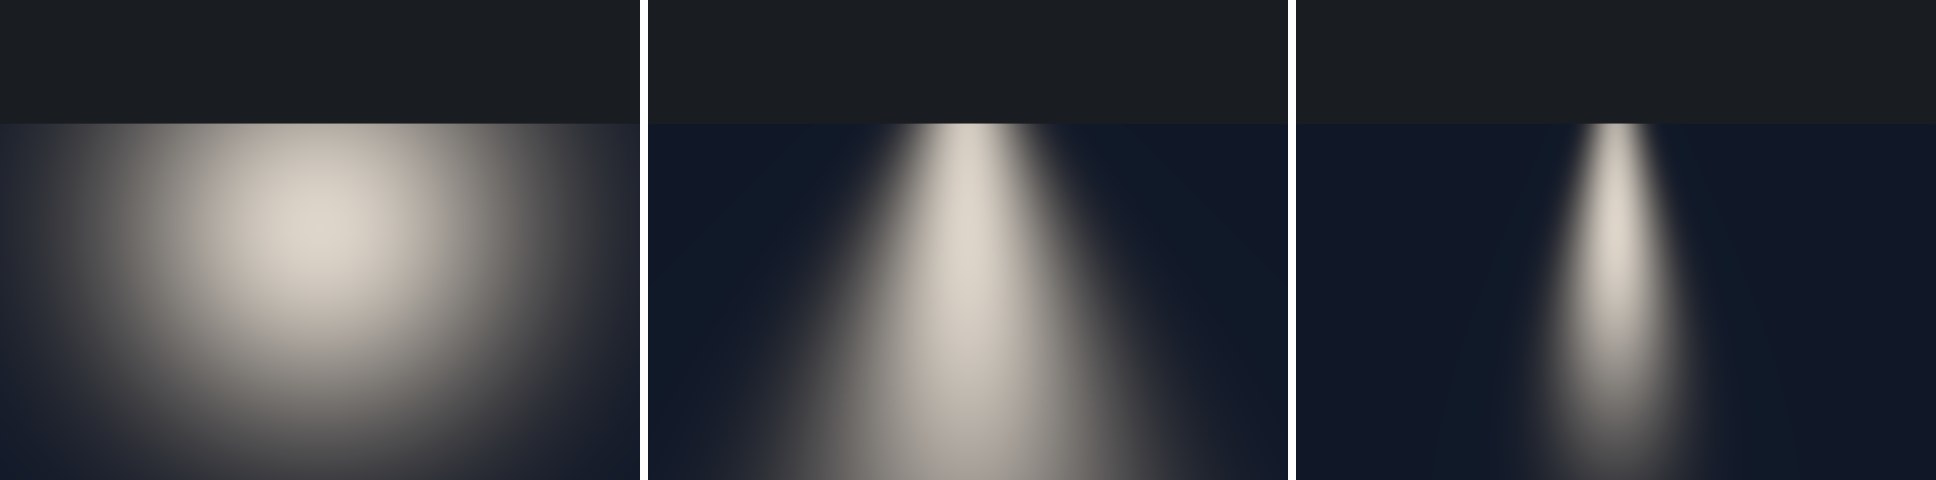
两者在正面观察时几乎一样,差别出现在掠射角:当光和视线都贴着表面时,Phong 的高光仍然是圆的,而 Blinn-Phong 的高光会沿着视线方向拉长成一条。现实中,夕阳照在湖面或湿马路上时,倒影总是拉成一条竖直的长条,这正是 Blinn-Phong 的样子——它更接近真实。
URP 自带的 Simple Lit 用的就是 Blinn-Phong,核心函数在 Lighting.hlsl 里:
half3 LightingSpecular(half3 lightColor, half3 lightDir, half3 normal, half3 viewDir, half4 specular, half smoothness)
{
    float3 halfVec = SafeNormalize(float3(lightDir) + float3(viewDir));
    half NdotH = half(saturate(dot(normal, halfVec)));
    half modifier = pow(NdotH, smoothness);
    float3 specularReflection = specular.rgb * modifier;
    return lightColor * specularReflection;
}

// CalculateBlinnPhong() 中:
half smoothness = exp2(10 * surfaceData.smoothness + 1);
可以看到两点:第一,名为 smoothness 的参数其实是高光指数,由材质面板上 0~1 的光滑度经过 exp2(10·s + 1) 映射而来,范围是 2 到 2048;这种指数映射让滑块在“粗糙”一侧变化平缓、在“光滑”一侧变化剧烈,手感更均匀。第二,它没有做归一化,也没有乘 N·L——这两点正是下一个案例要讨论的。
案例 5.6高光指数的能量归一化进阶单独打开 ↗
目标:理解为什么“调高高光指数,高光却变暗了”,推导 Phong 与 Blinn-Phong 的归一化系数,并在 URP 的 π 约定下正确使用它们。
问题
回头看图 5-11:n 从 2 增大到 512,高光变小了,但峰值亮度没变(始终是 ks),于是高光覆盖的总能量越来越少,最右边几乎看不到高光。可现实恰恰相反:越光滑的表面,反射越集中,高光应该越小、越亮——同样多的反射能量被挤进了更小的立体角里。美术只能一边调高光指数、一边手动调高 ks 来“补光”,两个参数纠缠在一起,很难调。
推导
解决办法是给波瓣乘上一个依赖 n 的系数 C(n),让波瓣在半球上的积分保持不变。以 Phong 为例,考虑光从正上方入射(此时 R = N,α 就是出射方向的极角 θ),要求反射的总能量等于 1:
积分里多出的那个 cos θ 是出射方向的投影因子(第 9 章讲渲染方程时会详细解释),sin θ dθ dφ 是立体角微元。对 Blinn-Phong,由于 N·H 与出射方向的关系更复杂,精确的归一化系数是一个较繁琐的表达式;实践中普遍使用一个误差很小的近似:
最后别忘了 5.1 节说的 π 约定:URP 的漫反射写作 albedo·N·L,没有除以 π,相当于整个 BRDF 被乘了 π。为了让高光与漫反射的比例保持正确,归一化系数也要乘 π,代码里实际使用的是 (n+2)/2 和 (n+8)/8。另外,归一化以后的高光被当作 BRDF 使用,它和漫反射一样,要乘上入射光的余弦 N·L——这一项在经典 Phong 里是没有的。
代码
// 返回“乘上 N·L 之后”的高光项,与 URP 的约定一致:漫反射写成 albedo * N·L(没有 1/π),
// 所以这里的归一化系数也整体乘了 π:Blinn-Phong 用 (n+8)/8,Phong 用 (n+2)/2
float SpecularTerm(float3 N, float3 L, float3 V, float n)
{
    float NdotL = saturate(dot(N, L));
#if defined(_MODEL_PHONG)
    float lobe = pow(saturate(dot(reflect(-L, N), V)), n);
    float norm = (n + 2.0) / 2.0;
#else
    float lobe = pow(saturate(dot(N, SafeNormalize(L + V))), n);
    float norm = (n + 8.0) / 8.0;
#endif
#if !defined(_NORMALIZE_SPECULAR)
    norm = 1.0;
#endif
    return norm * lobe * NdotL;
}
// 返回“乘上 N·L 之后”的高光项,与 URP 的约定一致:漫反射写成 albedo * N·L(没有 1/π),
// 所以这里的归一化系数也整体乘了 π:Blinn-Phong 用 (n+8)/8,Phong 用 (n+2)/2
float SpecularTerm(vec3 N, vec3 L, vec3 V, float n)
{
    float NdotL = saturate(dot(N, L));
#if defined(_MODEL_PHONG)
    float lobe = pow(saturate(dot(reflect(-L, N), V)), n);
    float norm = (n + 2.0) / 2.0;
#else
    float lobe = pow(saturate(dot(N, SafeNormalize(L + V))), n);
    float norm = (n + 8.0) / 8.0;
#endif
#if !defined(_NORMALIZE_SPECULAR)
    norm = 1.0;
#endif
    return norm * lobe * NdotL;
}
用 KeywordEnum 在 Phong 与 Blinn-Phong 之间切换,用 Toggle 控制是否归一化,四种组合都可以在材质上直接对比。
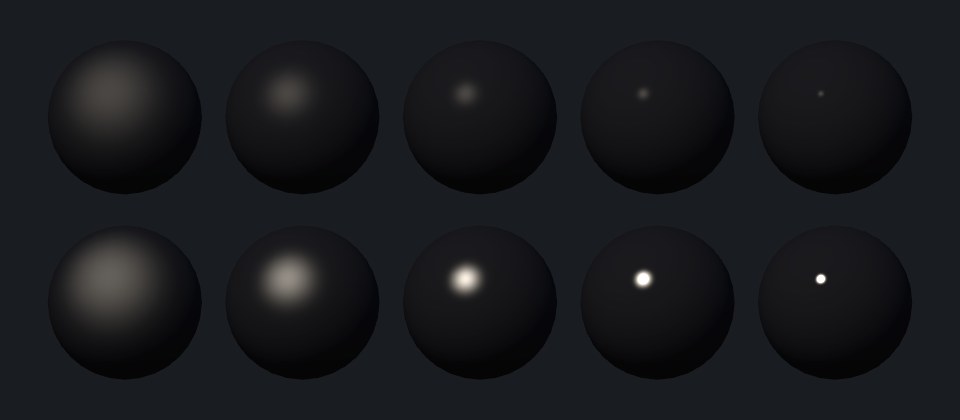
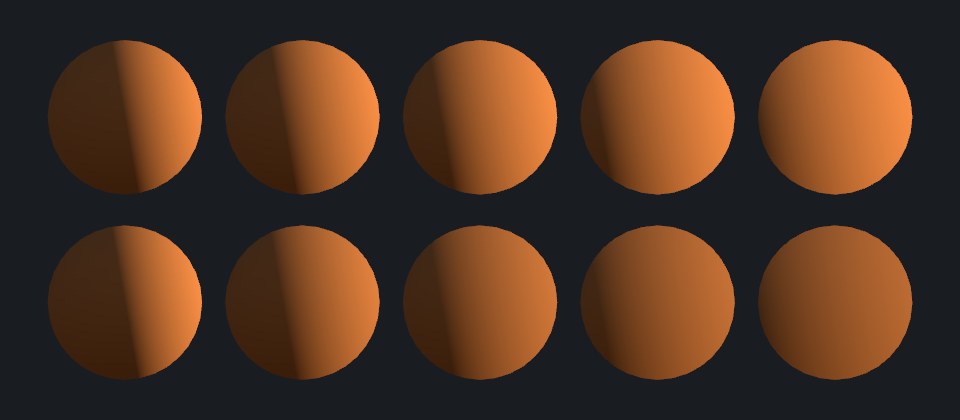
下排最右的两个球,高光中心已经超过 1 被截断成纯白,这在 HDR + 色调映射的管线里会表现为更自然的高亮,并可以触发 Bloom。归一化之后,美术只需要用 n(或光滑度)控制“表面有多光滑”,用 ks 控制“反射有多强”,两个参数各司其职。这正是 PBR 的核心思想之一,第 9 章的 GGX 分布同样是归一化的。
pow 的结果乘上这个系数容易超出 half 的范围(约 65504)产生 Inf。如果移动端出现高光处的黑点或白块,先检查这里的精度。案例 5.7粗糙漫反射:Oren-Nayar 与 Minnaert进阶单独打开 ↗
目标:理解为什么月亮、陶土、粗布在正面光照下“不够立体”,实现 Oren-Nayar 定性模型(并推导出一个不含三角函数的版本),以及更简单的 Minnaert 模型。
原理
满月看起来像一个亮度均匀的圆盘,边缘并没有像 Lambert 球那样变暗。原因在于月壤非常粗糙:表面由无数小坑和小斜面组成。在 Oren 和 Nayar 的模型里,粗糙表面被看成大量 V 形凹槽,每个小斜面本身是 Lambert 的。当光源和观察者在同一方向时,我们看到的恰好是那些朝向光源、被照亮的小斜面,而背光的斜面被挡在后面——即使宏观上表面已经倾斜到球的边缘,看到的仍然是亮面。于是粗糙表面呈现出“逆反射”(Retro-reflection)的特性:光从哪来,就更多地往哪里反射回去。
完整的 Oren-Nayar 模型包含遮挡、阴影和凹槽之间的相互反射,很复杂。它的论文同时给出了一个常用的“定性模型”(Qualitative Model):
θi、θr 是入射与出射方向的极角,φi − φr 是它们在切平面上投影的夹角,σ 是微斜面坡度的标准差(弧度),表示粗糙程度。σ = 0 时 A = 1、B = 0,退化成 Lambert。
去掉三角函数
直接照公式写,需要两次 acos、一次 sin、一次 tan,还要把 L、V 投影到切平面上求夹角,在 Shader 里很贵。其实可以完全用点积表达。记 s = L·V − (N·L)(N·V),把 L、V 用极坐标展开:
而 sin α · tan β = sin α · sin β / cos β = sin θi sin θr / max(cos θi, cos θr)(β 是较小的角,余弦较大)。两式相除:
这是一个精确的恒等变换,不是近似,结果只需要三次点积和一次除法。
// Oren-Nayar 定性模型,返回值已乘 N·L(URP 约定,不含 1/π)。
// 原式 A + B·max(0, cos(φi-φr))·sinα·tanβ 里的三角函数可以全部消掉:
//   s = L·V - (N·L)(N·V) = sinθi·sinθr·cos(φi-φr)
//   sinα·tanβ = sinθi·sinθr / max(cosθi, cosθr)
// 于是 cos(φi-φr)·sinα·tanβ = s / max(N·L, N·V)
float OrenNayar(float3 N, float3 L, float3 V, float sigma)
{
    float NdotL = saturate(dot(N, L));
    float NdotV = saturate(dot(N, V));
    float s2 = sigma * sigma;
    float A = 1.0 - 0.5 * s2 / (s2 + 0.33);
    float B = 0.45 * s2 / (s2 + 0.09);
    float s = dot(L, V) - NdotL * NdotV;
    float t = max(max(NdotL, NdotV), 1e-4);
    return NdotL * (A + B * max(0.0, s) / t);
}
// Oren-Nayar 定性模型,返回值已乘 N·L(URP 约定,不含 1/π)。
// 原式 A + B·max(0, cos(φi-φr))·sinα·tanβ 里的三角函数可以全部消掉:
//   s = L·V - (N·L)(N·V) = sinθi·sinθr·cos(φi-φr)
//   sinα·tanβ = sinθi·sinθr / max(cosθi, cosθr)
// 于是 cos(φi-φr)·sinα·tanβ = s / max(N·L, N·V)
float OrenNayar(vec3 N, vec3 L, vec3 V, float sigma)
{
    float NdotL = saturate(dot(N, L));
    float NdotV = saturate(dot(N, V));
    float s2 = sigma * sigma;
    float A = 1.0 - 0.5 * s2 / (s2 + 0.33);
    float B = 0.45 * s2 / (s2 + 0.09);
    float s = dot(L, V) - NdotL * NdotV;
    float t = max(max(NdotL, NdotV), 1e-4);
    return NdotL * (A + B * max(0.0, s) / t);
}
Minnaert 模型更早,也更简单,最初用来描述月面的亮度分布。它只有一个参数 k:
// Minnaert:k = 1 时就是 Lambert;k < 1 边缘变亮(天鹅绒、月面感),k > 1 边缘更暗
float Minnaert(float3 N, float3 L, float3 V, float k)
{
    float NdotL = saturate(dot(N, L));
    float NdotV = max(saturate(dot(N, V)), 1e-3);
    return pow(NdotL, k) * pow(NdotV, k - 1.0);
}
k = 1 时 N·V 的指数为 0,就是 Lambert;k < 1 时 (N·V)k−1 在边缘(N·V → 0)变大,轮廓变亮,适合天鹅绒、桃子绒毛一类材质;k > 1 则让边缘更暗。由于 k < 1 时边缘处会趋于无穷,代码里给 N·V 设了一个下限。
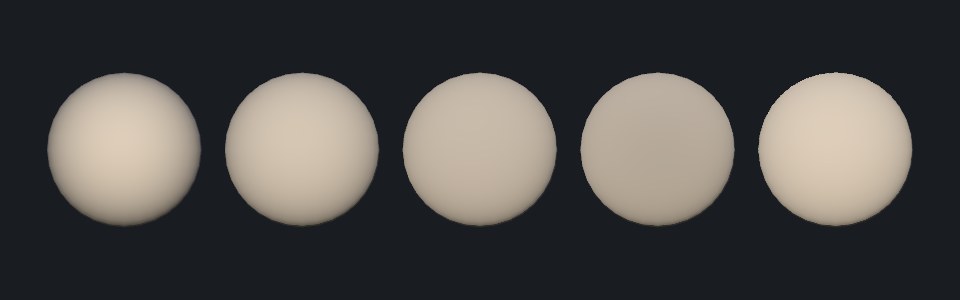
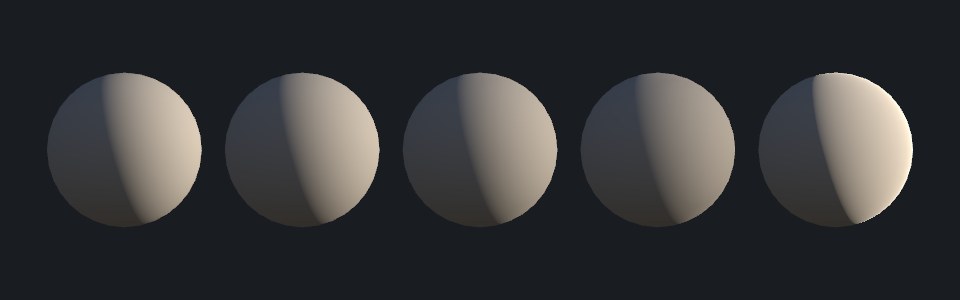
从图 5-17 还能看出一个问题:σ 越大,Oren-Nayar 球整体越暗。这是因为定性模型丢掉了凹槽之间的相互反射,能量并不守恒。对于需要精确能量的场合,可以考虑后来的改进模型;在游戏里,更常见的选择是第 9 章的 Disney(Burley)漫反射,它用很小的代价同时考虑了粗糙度对边缘亮度的影响。
案例 5.8逐顶点与逐像素光照入门单独打开 ↗
目标:把同一套 Blinn-Phong 分别放在顶点着色器和片元着色器里计算,直观看到 Gouraud 着色的问题,并知道它在今天还有什么用。
两个容易混淆的名字
“Phong”这个名字在图形学里指两样东西:一是案例 5.4 的 Phong 反射模型(怎么算一个点的亮度),二是 Phong 着色(Phong Shading,在三角形内部插值法线、逐像素计算光照)。与之对应的是 Gouraud 着色:在顶点上算好光照颜色,再在三角形内部插值颜色。两者可以与任何反射模型组合,比如“用 Gouraud 着色计算 Blinn-Phong 反射”。
代码
half3 ShadeBlinnPhong(float3 positionWS, float3 N)
{
    float3 V = GetWorldSpaceNormalizeViewDir(positionWS);
    Light mainLight = GetMainLight();
    float3 L = mainLight.direction;
    half3 radiance = mainLight.color * mainLight.distanceAttenuation;
    float NdotL = dot(N, L);
    float spec = pow(saturate(dot(N, SafeNormalize(L + V))), _Shininess) * step(0.0, NdotL);
    half3 color = (_BaseColor.rgb * saturate(NdotL) + _SpecColor.rgb * spec) * radiance;
    return color + _BaseColor.rgb * SampleSH(N) * _AmbientStrength;
}
vec3 ShadeBlinnPhong(vec3 positionWS, vec3 N)
{
    vec3 V = GetWorldSpaceNormalizeViewDir(positionWS);
    Light mainLight = GetMainLight();
    vec3 L = mainLight.direction;
    vec3 radiance = mainLight.color * mainLight.distanceAttenuation;
    float NdotL = dot(N, L);
    float spec = pow(saturate(dot(N, SafeNormalize(L + V))), _Shininess) * step(0.0, NdotL);
    vec3 color = (_BaseColor.rgb * saturate(NdotL) + _SpecColor.rgb * spec) * radiance;
    return color + _BaseColor.rgb * SampleSH(N) * _AmbientStrength;
}
Varyings vert(Attributes input)
{
    Varyings output;
    VertexPositionInputs pos = GetVertexPositionInputs(input.positionOS.xyz);
    float3 normalWS = TransformObjectToWorldNormal(input.normalOS);
    output.positionCS = pos.positionCS;
#if defined(_PER_VERTEX)
    output.color = ShadeBlinnPhong(pos.positionWS, normalWS);
#else
    output.positionWS = pos.positionWS;
    output.normalWS = normalWS;
#endif
    return output;
}

half4 frag(Varyings input) : SV_Target
{
#if defined(_PER_VERTEX)
    return half4(input.color, 1);
#else
    return half4(ShadeBlinnPhong(input.positionWS, normalize(input.normalWS)), 1);
#endif
}
#ifdef VERTEX
void main()
{
    VertexPositionInputs pos = GetVertexPositionInputs(positionOS.xyz);
    vec3 nWS = TransformObjectToWorldNormal(normalOS);
    gl_Position = pos.positionCS;
#if defined(_PER_VERTEX)
    vertexColor = ShadeBlinnPhong(pos.positionWS, nWS);
#else
    positionWS = pos.positionWS;
    normalWS = nWS;
#endif
}
#endif

#ifdef FRAGMENT
void main()
{
#if defined(_PER_VERTEX)
    fragColor = vec4(vertexColor, 1.0);
#else
    fragColor = vec4(ShadeBlinnPhong(positionWS, normalize(normalWS)), 1.0);
#endif
}
#endif
光照函数 ShadeBlinnPhong 只写一份,用 _PER_VERTEX 关键字决定在哪个阶段调用。注意 Varyings 结构体也随之变化:逐顶点时只需要传一个颜色,逐像素时要传世界坐标和法线。这里用的是 shader_feature_local(不带 _fragment 后缀),因为顶点和片元两个阶段都要看到这个关键字。
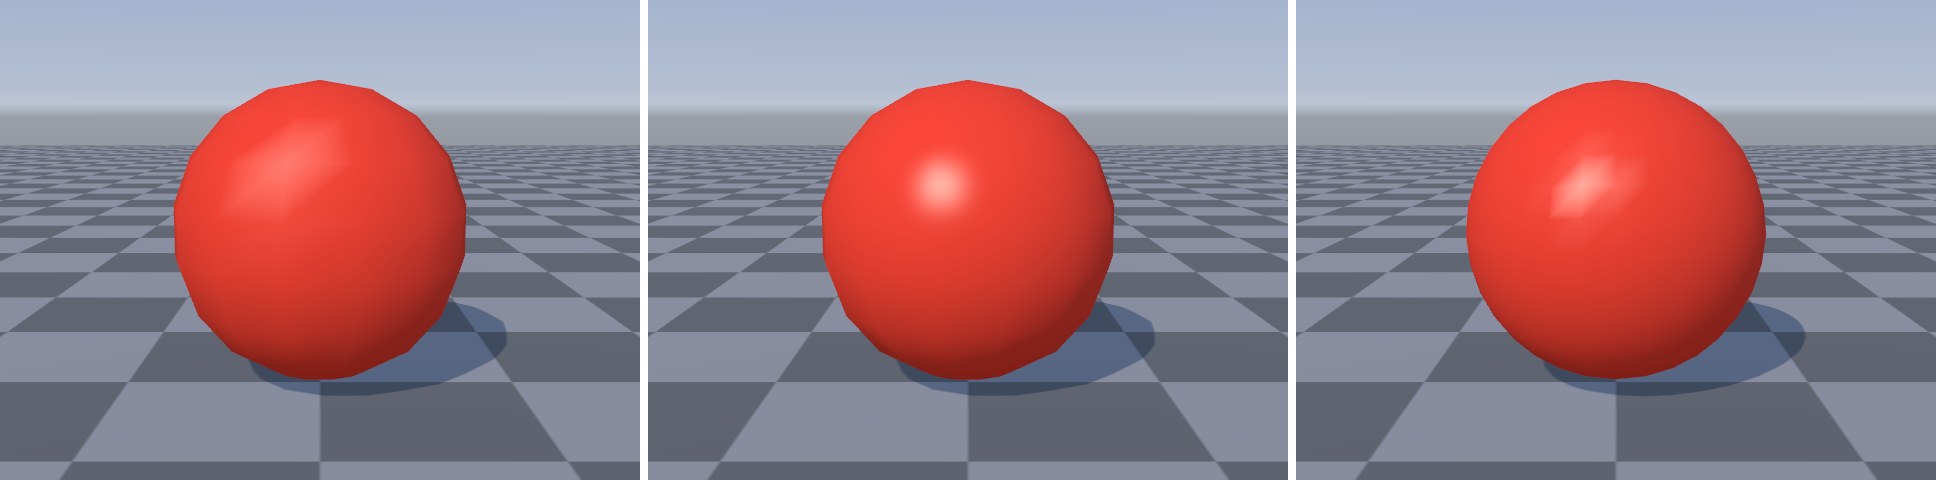
逐顶点光照的计算量与顶点数成正比,逐像素与像素数成正比。在早期硬件和今天的低端移动设备上,屏幕像素往往远多于顶点,逐顶点能省下大量计算。它的问题也很明确:任何在一个三角形内部变化剧烈的光照项都会出错,高光首当其冲,聚光灯的光斑边缘、点光源近处的衰减也一样。漫反射和环境光变化平缓,逐顶点计算的误差通常可以接受。
URP 里有两处正是这样用的:
- URP Asset 的 可以选 Per Vertex,此时 Shader 会被打开
_ADDITIONAL_LIGHTS_VERTEX关键字,附加光只在顶点里算 Lambert(URP 的VertexLighting()函数),用于低端设备,第 6 章会处理这个关键字。 - 球谐环境光可以选择逐顶点求值(
EVALUATE_SH_VERTEX)或混合求值(EVALUATE_SH_MIXED),因为环境光本来就很平滑。
✓ 适合逐顶点
环境光、漫反射、远景物体、大量的小型附加光、雾效因子、顶点密集的模型✗ 避免逐顶点
高光(尤其是高指数)、聚光灯边缘、近处点光源、低模的大平面、需要法线贴图的表面(法线贴图只能逐像素采样)案例 5.9经典光照函数库与实验台进阶单独打开 ↗
目标:把本章的模型整理成一个可复用的 HLSL 函数库,统一接口和约定;再做一个用关键字自由组合漫反射与高光的“实验台” Shader,方便对比和选型。
函数库
把散落在各个 Shader 里的公式收拢到一个 include 文件里,需要先统一约定,否则组合时很容易出错。这里的约定和 URP 保持一致:所有函数返回值已经乘过 N·L(或它的替代项),并且不除以 π;高光函数统一使用归一化版本。
// 案例 5.9 经典光照模型函数库。
// 约定(与 URP 一致):所有函数的返回值都已经乘过 N·L(或它的替代品),
// 而且没有除以 π——URP 的漫反射写作 albedo * lightColor * N·L,高光的归一化系数因此也整体乘了 π。
#ifndef COOKBOOK_CH05_CLASSIC_LIGHTING_INCLUDED
#define COOKBOOK_CH05_CLASSIC_LIGHTING_INCLUDED

float DiffuseLambert(float3 N, float3 L)
{
    return saturate(dot(N, L));
}

float DiffuseHalfLambert(float3 N, float3 L, float power)
{
    return pow(dot(N, L) * 0.5 + 0.5, power);
}

// 能量守恒的 Wrap:w = 0 时等于 Lambert
float DiffuseWrap(float3 N, float3 L, float w)
{
    return saturate((dot(N, L) + w) / ((1.0 + w) * (1.0 + w)));
}

// Oren-Nayar 定性模型(无三角函数版本),sigma 为微表面坡度的标准差(弧度)
float DiffuseOrenNayar(float3 N, float3 L, float3 V, float sigma)
{
    float NdotL = saturate(dot(N, L));
    float NdotV = saturate(dot(N, V));
    float s2 = sigma * sigma;
    float A = 1.0 - 0.5 * s2 / (s2 + 0.33);
    float B = 0.45 * s2 / (s2 + 0.09);
    float s = dot(L, V) - NdotL * NdotV;
    return NdotL * (A + B * max(0.0, s) / max(max(NdotL, NdotV), 1e-4));
}

// 归一化 Phong:(n+2)/2 · (R·V)^n · N·L
float SpecularPhong(float3 N, float3 L, float3 V, float n)
{
    float RdotV = saturate(dot(reflect(-L, N), V));
    return (n + 2.0) * 0.5 * pow(RdotV, n) * saturate(dot(N, L));
}

// 归一化 Blinn-Phong:(n+8)/8 · (N·H)^n · N·L
float SpecularBlinnPhong(float3 N, float3 L, float3 V, float n)
{
    float3 H = SafeNormalize(L + V);
    return (n + 8.0) * 0.125 * pow(saturate(dot(N, H)), n) * saturate(dot(N, L));
}

// 用 0~1 的“光滑度”驱动高光指数,映射与 URP SimpleLit 相同:smoothness=0 → 2,=1 → 2048
float ShininessFromSmoothness(float smoothness)
{
    return exp2(10.0 * smoothness + 1.0);
}

#endif
// 案例 5.9 经典光照模型函数库(GLSL 版,对应 Ch05/ClassicLighting.hlsl)。
// 约定(与 URP 一致):所有函数的返回值都已经乘过 N·L(或它的替代品),
// 而且没有除以 π——URP 的漫反射写作 albedo * lightColor * N·L,高光的归一化系数因此也整体乘了 π。
#ifndef COOKBOOK_CH05_CLASSIC_LIGHTING_INCLUDED
#define COOKBOOK_CH05_CLASSIC_LIGHTING_INCLUDED

float DiffuseLambert(vec3 N, vec3 L)
{
    return saturate(dot(N, L));
}

float DiffuseHalfLambert(vec3 N, vec3 L, float power)
{
    return pow(dot(N, L) * 0.5 + 0.5, power);
}

// 能量守恒的 Wrap:w = 0 时等于 Lambert
float DiffuseWrap(vec3 N, vec3 L, float w)
{
    return saturate((dot(N, L) + w) / ((1.0 + w) * (1.0 + w)));
}

// Oren-Nayar 定性模型(无三角函数版本),sigma 为微表面坡度的标准差(弧度)
float DiffuseOrenNayar(vec3 N, vec3 L, vec3 V, float sigma)
{
    float NdotL = saturate(dot(N, L));
    float NdotV = saturate(dot(N, V));
    float s2 = sigma * sigma;
    float A = 1.0 - 0.5 * s2 / (s2 + 0.33);
    float B = 0.45 * s2 / (s2 + 0.09);
    float s = dot(L, V) - NdotL * NdotV;
    return NdotL * (A + B * max(0.0, s) / max(max(NdotL, NdotV), 1e-4));
}

// 归一化 Phong:(n+2)/2 · (R·V)^n · N·L
float SpecularPhong(vec3 N, vec3 L, vec3 V, float n)
{
    float RdotV = saturate(dot(reflect(-L, N), V));
    return (n + 2.0) * 0.5 * pow(RdotV, n) * saturate(dot(N, L));
}

// 归一化 Blinn-Phong:(n+8)/8 · (N·H)^n · N·L
float SpecularBlinnPhong(vec3 N, vec3 L, vec3 V, float n)
{
    vec3 H = SafeNormalize(L + V);
    return (n + 8.0) * 0.125 * pow(saturate(dot(N, H)), n) * saturate(dot(N, L));
}

// 用 0~1 的“光滑度”驱动高光指数,映射与 URP SimpleLit 相同:smoothness=0 → 2,=1 → 2048
float ShininessFromSmoothness(float smoothness)
{
    return exp2(10.0 * smoothness + 1.0);
}

#endif
注意 Half-Lambert 函数本身没有乘 N·L:它的整个意义就是用 0.5·N·L + 0.5 去代替 N·L。这也是为什么约定里要写“或它的替代项”。ShininessFromSmoothness 与 URP Simple Lit 采用同样的映射,这样同一套贴图在两个 Shader 之间切换时手感一致。
实验台 Shader
half4 frag(Varyings input) : SV_Target
{
    half3 albedo = SAMPLE_TEXTURE2D(_BaseMap, sampler_BaseMap, input.uv).rgb * _BaseColor.rgb;
    float3 N = normalize(input.normalWS);
    float3 V = GetWorldSpaceNormalizeViewDir(input.positionWS);
    Light mainLight = GetMainLight();
    float3 L = mainLight.direction;
    half3 radiance = mainLight.color * mainLight.distanceAttenuation;

#if defined(_DIFFUSE_HALFLAMBERT)
    float d = DiffuseHalfLambert(N, L, 2.0);
#elif defined(_DIFFUSE_WRAP)
    float d = DiffuseWrap(N, L, _Wrap);
#elif defined(_DIFFUSE_ORENNAYAR)
    float d = DiffuseOrenNayar(N, L, V, _Roughness);
#else
    float d = DiffuseLambert(N, L);
#endif

    float n = ShininessFromSmoothness(_Smoothness);
#if defined(_SPECULAR_PHONG)
    float s = SpecularPhong(N, L, V, n);
#elif defined(_SPECULAR_BLINNPHONG)
    float s = SpecularBlinnPhong(N, L, V, n);
#else
    float s = 0.0;
#endif

    half3 color = (albedo * d + _SpecColor.rgb * s) * radiance;
    color += albedo * SampleSH(N) * _AmbientStrength;
    return half4(color, 1);
}
void main()
{
    vec3 albedo = texture(_BaseMap, uv).rgb * _BaseColor.rgb;
    vec3 N = normalize(normalWS);
    vec3 V = GetWorldSpaceNormalizeViewDir(positionWS);
    Light mainLight = GetMainLight();
    vec3 L = mainLight.direction;
    vec3 radiance = mainLight.color * mainLight.distanceAttenuation;

#if defined(_DIFFUSE_HALFLAMBERT)
    float d = DiffuseHalfLambert(N, L, 2.0);
#elif defined(_DIFFUSE_WRAP)
    float d = DiffuseWrap(N, L, _Wrap);
#elif defined(_DIFFUSE_ORENNAYAR)
    float d = DiffuseOrenNayar(N, L, V, _Roughness);
#else
    float d = DiffuseLambert(N, L);
#endif

    float n = ShininessFromSmoothness(_Smoothness);
#if defined(_SPECULAR_PHONG)
    float s = SpecularPhong(N, L, V, n);
#elif defined(_SPECULAR_BLINNPHONG)
    float s = SpecularBlinnPhong(N, L, V, n);
#else
    float s = 0.0;
#endif

    vec3 color = (albedo * d + _SpecColor.rgb * s) * radiance;
    color += albedo * SampleSH(N) * _AmbientStrength;
    fragColor = vec4(color, 1.0);
}
两个 KeywordEnum 分别生成 4 个和 3 个关键字,用 shader_feature_local_fragment 声明,共 12 种组合,只有实际被材质用到的组合才会进入构建。
new Material(shader) 时会按属性的默认值自动打开对应的关键字(例如默认值 0 会打开 _DIFFUSE_LAMBERT)。之后如果只调用 EnableKeyword("_DIFFUSE_WRAP"),两个关键字会同时打开,最终用哪个变体取决于代码里 #if 的先后顺序,表现为“改了没反应”。正确做法是同时设置属性值、打开目标关键字、关闭同组其它关键字。本书配图脚本里的 SetKeywordEnum() 辅助函数就是做这件事的。
怎么选
| 模型 | 相对开销 | 观感 | 典型用途 |
|---|---|---|---|
| Lambert | 1 次点积 | 标准、交界线清晰 | 一切漫反射的默认选择,PBR 的漫反射项 |
| Half-Lambert | Lambert + 1 次乘加(+ 平方) | 暗部通透、对比低 | 卡通、角色、无 GI 的移动端 |
| Wrap(守恒) | Lambert + 1 次除法 | 交界线柔和,可染色 | 皮肤、蜡、植物叶片的廉价近似 |
| Oren-Nayar | 3 次点积 + 1 次除法 | 粗糙、正面光下平坦 | 岩石、陶土、粗布、月面 |
| Minnaert | 2 次 pow | 边缘可亮可暗 | 天鹅绒、绒毛、风格化 |
| Phong | reflect + pow | 圆形高光 | 历史意义,少用 |
| Blinn-Phong | normalize + pow | 掠射时高光拉长,更真实 | 经典高光的默认选择,Simple Lit |
5.3 颜色、强度与精度:几个容易忽略的细节
线性空间
所有光照计算都必须在线性空间进行:光的叠加和乘法只有在线性值上才有物理意义。Unity 的 设为 Linear 时,标记为 sRGB 的贴图在采样时会自动转回线性,颜色属性(Color 类型)也会在传给 GPU 前转换,输出到 sRGB 帧缓冲时再由硬件编码回 Gamma。整个过程对 Shader 透明,我们只需保证“不要自己再做一次 pow(2.2)”。如果工程仍在 Gamma 空间,Lambert 的明暗过渡会显得过于生硬、交界线偏暗,多光源叠加时还会过曝,这是很多“光照看起来不对”的根源。
HDR 与截断
光照结果大于 1 是完全正常的:一盏强度为 3 的灯、一个归一化的锐利高光,都会产生远大于 1 的值。URP Asset 打开 HDR 后,相机的颜色缓冲是浮点格式,这些值会被保留到后处理,由 Tonemapping 映射到显示范围,并驱动 Bloom。关闭 HDR 时,颜色在写入缓冲时就被截断到 [0, 1],亮部细节全部丢失。本章的配图为了展示 Shader 的原始输出关闭了后处理,所以你会看到一些纯白的截断区域。
half 还是 float
URP 的源码里大量使用 half。在桌面 GPU 上 half 通常按 float 计算,没有区别;在移动 GPU 上 half 是真正的 16 位浮点,最大值约 65504、有效位数约 3 位十进制,可以省寄存器和带宽。经验法则是:颜色、法线、点积结果用 half 足够;位置、UV、深度、高光指数和 pow 的结果用 float。Light 结构体里 distanceAttenuation 特意声明成 float,注释写着“某些平台需要全精度”,就是这个原因。
零向量与 NaN
normalize(v) 在 v 为零向量时会产生 NaN,而 NaN 会像病毒一样传染:参与运算的一切结果都变成 NaN,在屏幕上通常表现为黑点或白点,在开了 Bloom 和 TAA 的管线里还会“扩散”成大块的黑斑。半程向量 L + V、插值后可能退化的法线都是高危地点,URP 提供的 SafeNormalize 会在长度过小时返回零向量。
5.4 与 Built-in 管线的差异
如果你从 Built-in 管线迁移过来,下表列出了本章涉及的写法对照。Built-in 的 Surface Shader 在 URP 中不再可用,光照必须像本章这样手写,或者调用 URP 提供的函数。
| Built-in(UnityCG / Lighting.cginc) | URP 14 | 说明 |
|---|---|---|
_WorldSpaceLightPos0 | GetMainLight().direction | URP 的主光源方向已归一化 |
_LightColor0 | GetMainLight().color | 都已乘 Intensity |
UnityWorldSpaceViewDir() | GetWorldSpaceNormalizeViewDir() | URP 版已归一化,并处理正交相机 |
UnityObjectToWorldNormal() | TransformObjectToWorldNormal() | 默认归一化 |
ShadeSH9() | SampleSH() | 球谐环境光,第 8 章 |
Tags { "LightMode"="ForwardBase" } | "LightMode"="UniversalForward" | URP 单 Pass 处理所有光源,没有 ForwardAdd |
Surface Shader 的 Lambert / BlinnPhong | LightingLambert() / LightingSpecular(),或整套 UniversalFragmentBlinnPhong() | URP 无 Surface Shader |
最大的结构性差异在多光源:Built-in 的前向渲染为每盏额外的逐像素光再画一遍物体(ForwardAdd Pass,叠加混合),而 URP 在一个 Pass 里循环所有光源。这意味着本章的单光源 Shader 扩展成多光源时,只需要加一个循环,而不需要第二个 Pass——下一章就从这里开始。
本章小结
- 经典光照 = 环境光 + 漫反射 + 高光,三者都是经验近似;它们是 PBR 的基础,也是移动端和风格化渲染的常用工具。
GetMainLight()返回的Light中,direction 指向光源,color 已乘强度且为线性 HDR 值,主光源也要乘distanceAttenuation。- Lambert 来自余弦定律;Unity 的灯光强度预先乘了 π,所以漫反射写作 albedo·color·N·L,从论文搬来的 BRDF 要整体乘 π。
- Half-Lambert 和 Wrap 让光“绕过”交界线;Wrap 的能量守恒版本分母为 (1+w)²,配合交界线染色可做廉价的皮肤感。
- Phong 比较 R 与 V,Blinn-Phong 比较 N 与 H;后者在掠射角下高光拉长、更真实,H 是微表面理论的核心。
- 高光要归一化:Phong 乘 (n+2)/2,Blinn-Phong 乘 (n+8)/8(已含 π),并乘 N·L,这样光滑度与反射强度才能解耦。
- Oren-Nayar 与 Minnaert 模拟粗糙表面的逆反射,Oren-Nayar 定性模型可以化简为只含点积的形式。
- 逐顶点(Gouraud)着色适合平滑的光照项,不适合高光;URP 的逐顶点附加光、逐顶点球谐都是这一思想的应用。
练习
- 把案例 5.1 的 Lambert 改成“双面光照”:背光面使用
saturate(-NdotL)乘一个较暗的颜色,模拟树叶的透光。思考它和 Half-Lambert 有什么不同。 - 在 Blinn-Phong Shader 里加入简单的能量分配:漫反射乘
(1 − max(ks.r, ks.g, ks.b)),对比加入前后高光很强的材质有什么变化。 - 用 Wrap Lighting 的思路,给 Blinn-Phong 的高光也做一个“柔化”版本,让高光边缘更宽。它在什么风格下有用?
- 对一个 8×6 段的低模球,同时打开逐顶点光照和一张很小的高光指数(n = 4)。观察高光是否还有多边形痕迹,并解释原因。
- 阅读 URP 的
UniversalFragmentBlinnPhong()(Lighting.hlsl),找出它和案例 5.9 实验台在高光计算上的两处不同。