案例 11.6环境 BRDF:解析近似与程序生成的 DFG LUT高阶
目标:实现 split-sum 的右半,给出两种方案,并量化它们的差异。
把 Schlick 菲涅尔代入右半积分,F0 可以提到积分外面:
A、B 只是 NoV 和粗糙度的函数。方案一是 Karis 2014 年在《Physically Based Shading on Mobile》中给出的解析拟合,十几条 ALU 指令,不需要贴图;方案二是自己把积分算出来,存成一张 64×64 的 RG 贴图。
// 环境 BRDF(split-sum 的第二项):∫ f_s cosθ dω = F0 * A + F90 * B
// 解析近似:Karis 2014《Physically Based Shading on Mobile》中的拟合,输入感知粗糙度
float2 MyEnvDFGApprox(float NoV, float perceptualRoughness)
{
    const float4 c0 = float4(-1.0, -0.0275, -0.572, 0.022);
    const float4 c1 = float4( 1.0,  0.0425,  1.040, -0.040);
    float4 r = perceptualRoughness * c0 + c1;
    float a004 = min(r.x * r.x, exp2(-9.28 * NoV)) * r.x + r.y;
    return float2(-1.04, 1.04) * a004 + r.zw;          // x = A(乘 F0),y = B(乘 F90)
}

// 程序生成的 LUT:u = NoV,v = 感知粗糙度;生成代码见 DFGLut.cs
float2 MyEnvDFG(float NoV, float perceptualRoughness)
{
#if defined(_DFG_LUT)
    return SAMPLE_TEXTURE2D_LOD(_DFGLut, sampler_LinearClamp, float2(NoV, perceptualRoughness), 0).rg;
#else
    return MyEnvDFGApprox(NoV, perceptualRoughness);
#endif
}

// 多次散射能量补偿(Kulla-Conty 思路的廉价版本,Fdez-Agüero 2019 / Filament 的做法):
// 单次散射的方向反照率 Ess = A + B(取 F0 = 1),丢掉的能量是 1 - Ess。
// 把镜面整体放大 1 + F0 (1/Ess - 1),粗糙金属不再“越粗越暗”。
float3 MyEnergyCompensation(float2 dfg, float3 f0)
{
    float Ess = max(dfg.x + dfg.y, 1e-4);
    return 1.0 + f0 * (1.0 / Ess - 1.0);
}

// 镜面遮蔽:由 AO 推一个对镜面也合理的遮蔽量(Lagarde & de Rousiers 2014 的经验公式)
float MySpecularOcclusion(float NoV, float ao, float perceptualRoughness)
{
    float a = perceptualRoughness * perceptualRoughness;
    return saturate(pow(abs(NoV + ao), exp2(-16.0 * a - 1.0)) - 1.0 + ao);
}

// 感知粗糙度 -> 预滤波 cubemap 的 mip 级。UNITY_SPECCUBE_LOD_STEPS = 6(最后一级的序号)。
// 非线性映射让低粗糙度区间分到更多 mip 级(与 URP 的取法一致,便于对照)。
float MyRoughnessToMip(float perceptualRoughness)
{
    return perceptualRoughness * (1.7 - 0.7 * perceptualRoughness) * UNITY_SPECCUBE_LOD_STEPS;
}
// 环境 BRDF(split-sum 的第二项):∫ f_s cosθ dω = F0 * A + F90 * B
// 解析近似:Karis 2014《Physically Based Shading on Mobile》中的拟合,输入感知粗糙度
vec2 MyEnvDFGApprox(float NoV, float perceptualRoughness)
{
    const vec4 c0 = vec4(-1.0, -0.0275, -0.572, 0.022);
    const vec4 c1 = vec4( 1.0,  0.0425,  1.040, -0.040);
    vec4 r = perceptualRoughness * c0 + c1;
    float a004 = min(r.x * r.x, exp2(-9.28 * NoV)) * r.x + r.y;
    return vec2(-1.04, 1.04) * a004 + r.zw;          // x = A(乘 F0),y = B(乘 F90)
}

// 程序生成的 LUT:u = NoV,v = 感知粗糙度;生成代码见 DFGLut.cs
vec2 MyEnvDFG(float NoV, float perceptualRoughness)
{
#if defined(_DFG_LUT)
    return textureLod(_DFGLut, vec2(NoV, perceptualRoughness), 0.0).rg;
#else
    return MyEnvDFGApprox(NoV, perceptualRoughness);
#endif
}

// 多次散射能量补偿(Kulla-Conty 思路的廉价版本,Fdez-Agüero 2019 / Filament 的做法):
// 单次散射的方向反照率 Ess = A + B(取 F0 = 1),丢掉的能量是 1 - Ess。
// 把镜面整体放大 1 + F0 (1/Ess - 1),粗糙金属不再“越粗越暗”。
vec3 MyEnergyCompensation(vec2 dfg, vec3 f0)
{
    float Ess = max(dfg.x + dfg.y, 1e-4);
    return 1.0 + f0 * (1.0 / Ess - 1.0);
}

// 镜面遮蔽:由 AO 推一个对镜面也合理的遮蔽量(Lagarde & de Rousiers 2014 的经验公式)
float MySpecularOcclusion(float NoV, float ao, float perceptualRoughness)
{
    float a = perceptualRoughness * perceptualRoughness;
    return saturate(pow(abs(NoV + ao), exp2(-16.0 * a - 1.0)) - 1.0 + ao);
}

// 感知粗糙度 -> 预滤波 cubemap 的 mip 级。UNITY_SPECCUBE_LOD_STEPS = 6(最后一级的序号)。
// 非线性映射让低粗糙度区间分到更多 mip 级(与 URP 的取法一致,便于对照)。
float MyRoughnessToMip(float perceptualRoughness)
{
    return perceptualRoughness * (1.7 - 0.7 * perceptualRoughness) * UNITY_SPECCUBE_LOD_STEPS;
}
LUT 的生成用 C# 在 CPU 上完成,算法是标准的 GGX 重要性采样:
public static Texture2D Generate(int size = 64, int sampleCount = 512)
{
    var tex = new Texture2D(size, size, TextureFormat.RGBAHalf, false, true)   // 线性、无 mip
    {
        name = "MyPBR_DFG_LUT",
        wrapMode = TextureWrapMode.Clamp,
        filterMode = FilterMode.Bilinear
    };
    var px = new Color[size * size];
    for (int y = 0; y < size; y++)
    {
        float perceptualRoughness = (y + 0.5f) / size;   // 取像素中心,双线性采样时才对得上
        float a = perceptualRoughness * perceptualRoughness;
        for (int x = 0; x < size; x++)
        {
            float NoV = (x + 0.5f) / size;
            Vector2 ab = Integrate(NoV, a, sampleCount);
            px[y * size + x] = new Color(ab.x, ab.y, 0, 1);
        }
    }
    tex.SetPixels(px);
    tex.Apply(false, false);
    return tex;
}

static Vector2 Integrate(float NoV, float a, int sampleCount)
{
    // 切线空间里 N = (0,0,1),V 放在 xz 平面
    var V = new Vector3(Mathf.Sqrt(1f - NoV * NoV), 0f, NoV);
    float a2 = a * a;
    float A = 0, B = 0;
    for (int i = 0; i < sampleCount; i++)
    {
        Vector2 xi = Hammersley(i, sampleCount);
        Vector3 H = ImportanceSampleGGX(xi, a2);
        Vector3 L = 2f * Vector3.Dot(V, H) * H - V;
        float NoL = Mathf.Clamp01(L.z);
        float NoH = Mathf.Clamp01(H.z);
        float VoH = Mathf.Clamp01(Vector3.Dot(V, H));
        if (NoL <= 0f) continue;

        // pdf(L) = D · NoH / (4 VoH);被积函数 f_s·NoL = D·V·F·NoL
        // 两者相除 D 消掉:F · V · 4 · NoL · VoH / NoH
        float vis = SmithGGXCorrelated(NoV, NoL, a2);
        float gv = vis * 4f * NoL * VoH / Mathf.Max(NoH, 1e-6f);
        float fc = Mathf.Pow(1f - VoH, 5f);
        A += (1f - fc) * gv;
        B += fc * gv;
    }
    return new Vector2(A / sampleCount, B / sampleCount);
}

// 与 HLSL 的 MyV_SmithGGXCorrelated 逐字对应
static float SmithGGXCorrelated(float NoV, float NoL, float a2)
{
    float lv = NoL * Mathf.Sqrt((NoV - NoV * a2) * NoV + a2);
    float ll = NoV * Mathf.Sqrt((NoL - NoL * a2) * NoL + a2);
    return 0.5f / Mathf.Max(lv + ll, 1e-5f);
}

// GGX 重要性采样:按 D(h)·NoH 的分布抽半角向量
static Vector3 ImportanceSampleGGX(Vector2 xi, float a2)
{
    float phi = 2f * Mathf.PI * xi.x;
    float cosTheta = Mathf.Sqrt((1f - xi.y) / (1f + (a2 - 1f) * xi.y));
    float sinTheta = Mathf.Sqrt(1f - cosTheta * cosTheta);
    return new Vector3(sinTheta * Mathf.Cos(phi), sinTheta * Mathf.Sin(phi), cosTheta);
}

// 低差异序列:比纯随机数收敛快得多,512 个样本就很平滑
static Vector2 Hammersley(int i, int n)
{
    uint bits = (uint)i;
    bits = (bits << 16) | (bits >> 16);
    bits = ((bits & 0x55555555u) << 1) | ((bits & 0xAAAAAAAAu) >> 1);
    bits = ((bits & 0x33333333u) << 2) | ((bits & 0xCCCCCCCCu) >> 2);
    bits = ((bits & 0x0F0F0F0Fu) << 4) | ((bits & 0xF0F0F0F0u) >> 4);
    bits = ((bits & 0x00FF00FFu) << 8) | ((bits & 0xFF00FF00u) >> 8);
    return new Vector2((float)i / n, bits * 2.3283064365386963e-10f);
}
几个要点。第一,被积函数里的 D 被重要性采样的概率密度消掉了:按 抽取半角向量,换算到入射方向的概率密度是 ,被积函数除以它,剩下 。第二,可见性项用的是与直接光完全相同的 SmithGGXCorrelated,这样直接光和环境光的“镜面模型”是同一个。第三,用 Hammersley 低差异序列代替随机数,512 个样本就足够平滑。第四,采样坐标取像素中心 (i + 0.5) / size,与 GPU 双线性采样的约定一致。菜单 (Editor/DFGLutBaker.cs)会把它存成资产,拖进材质的 DFG LUT 槽并勾选 Use DFG LUT 即可。
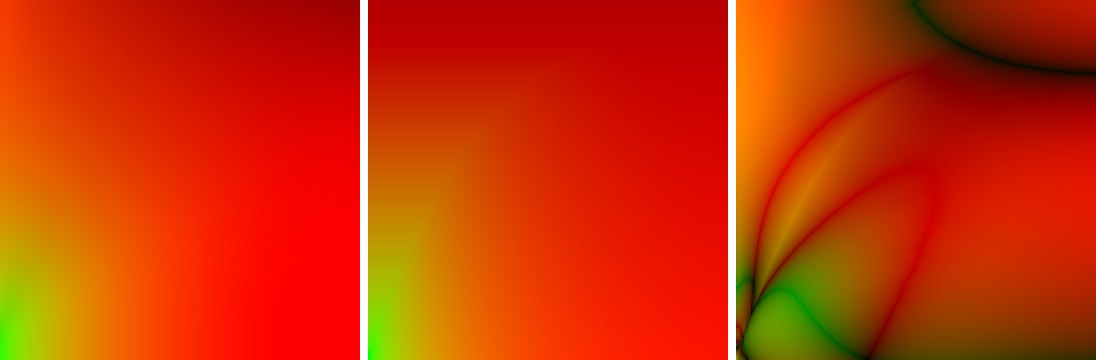
两张表大体形状一致:光滑且正视时 A≈1、B≈0(几乎全部由 F0 决定);掠射时 B 变大(菲涅尔把反射推向白色);粗糙时整体变暗。但差异图告诉我们,两者并不相同。配图脚本把逐像素误差统计打印到了日志里:在 64×64 的网格上,A 的最大差约 0.46、平均差约 0.11,B 的最大差约 0.09、平均差约 0.01,最大差出现在“高粗糙度 + 掠射角”一角。原因不是拟合不准那么简单——按 Karis 的课程笔记,这个拟合的对象是 UE4 当年的 LUT,那张表用的是可分离的 Schlick-Smith 几何项(环境光取 k = α/2);我们的表用的是高度相关 Smith,遮挡估计更少,粗糙表面在掠射时保留了更多能量。两种模型都“对”,但直接光和环境光最好用同一个模型,否则同一个材质在灯下和在环境里会显得不像同一种东西。所以 MyPBR 默认在配图中启用 LUT,解析近似留给不想多一张贴图、多一次采样的移动端。
Shader.SetGlobalTexture 设成全局贴图,并把 _DFGLut 从 Properties 里删掉(材质属性会覆盖同名全局变量)。这样不用每个材质都拖一次。本章为了让材质自包含、便于对比两种方案,保留了材质属性的写法。